
想在自己电脑上跑大模型,最常见的问题不是「能不能跑」,而是「跑起来有多快」。网上的说法一般是「4090 跑 Qwen 每秒 100 多 token」,可每秒 100 token 到底是什么感觉?换成 Mac mini 会慢多少?丢一份长文档进去要等几秒才开始出字?这些光看数字很难想象。
llmspeed 就是解决这个问题的:选一块显卡或一台 Mac,再选一个模型,它会按估算的速度把回答一个字一个字「打」出来,连出第一个字之前的等待时间也模拟进去。买硬件之前花两分钟试一下,比看一堆跑分表直观。
这篇先讲怎么用、数字怎么看,再把我从它的数据里整理出的几组典型配置放成表,最后说说它的局限。资料和数据查阅于 2026 年 10 月 18 日(北京时间),数据文件版本为 2026-10-17。
llmspeed 是什么
- 网址:llmspeed.dev,打开就能用,不用注册,也不用安装。
- 开源:GitHub 仓库 nicorobinreal/llmspeed,MIT 协议,写这篇时约 70 多颗星,是个很新的小项目,这两天上了 Hacker News 首页。
- 收录范围:30 种显卡、Mac 和 CPU,15 个热门开源模型,覆盖 CUDA(N 卡)、Metal(Mac)、ROCm(A 卡)、Vulkan 和纯 CPU。
- 能做的事:实时模拟出字速度;两套配置并排「赛跑」;判断模型在某个量化版本下能不能装进显存;生成分享链接。
三步用起来
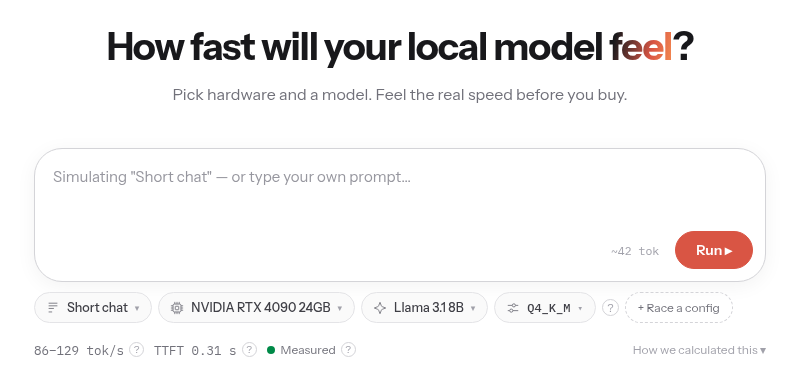
- 选提示词长度。 左边第一个下拉框有 4 个预设:Short chat(短问题,约 42 token)、Email draft(写邮件,约 290 token)、Code file(一份代码文件,约 1800 token)、20-page doc(20 页文档,约 12500 token)。也可以直接在输入框里写自己的提示词。提示词越长,出第一个字前等得越久,这一项对比 Mac 和 N 卡时特别有用。
- 选硬件、模型和量化。 量化可以理解成「压缩」:Q4_K_M 体积小、速度快,Q8_0 更接近原版,FP16 是不压缩的原版。选完下面会显示每秒能出多少 token(tok/s)、首字等待时间(TTFT),以及这个数字的可信度。
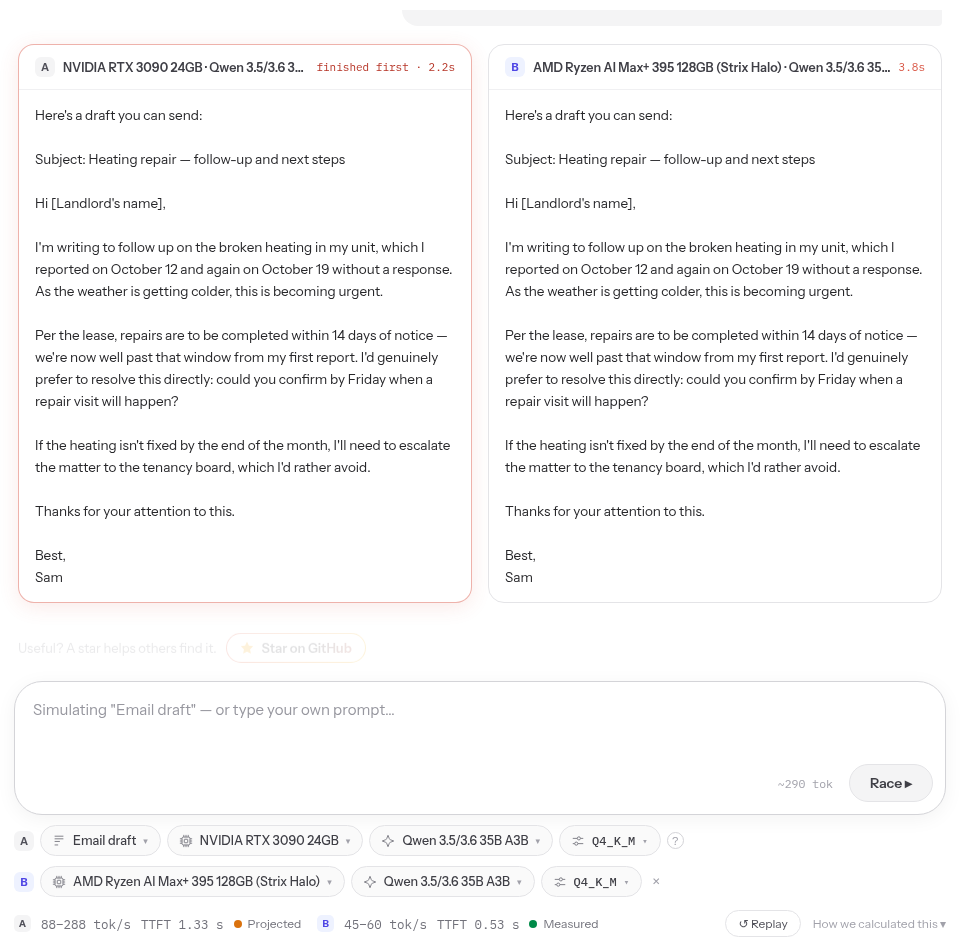
- 点 Run 看效果。 想对比两套配置就点「+ Race a config」,两边会同时开始出字,谁先写完一目了然。设置好的组合可以点 Share 复制链接发给别人。
先看懂三种标签
每个速度后面都有一个标签,告诉你这个数字有多可靠,这是 llmspeed 我最喜欢的设计:
- Measured(实测):有人在这台硬件、这个模型、这个量化版本上真跑过。数据来自 r/LocalLLaMA、localscore.ai、llama.cpp 讨论区等社区分享。
- Derived(推算):没有完全一样的实测,用相近配置的实测数据推出来的。
- Projected(估算):没有可参考的实测,按硬件参数算的。比如还没发售的硬件,或者模型装不下、要分一部分到内存里的情况。
建议主要看「实测」,「推算」的区间往往很宽(比如 94–297 tok/s),只能当个大概。
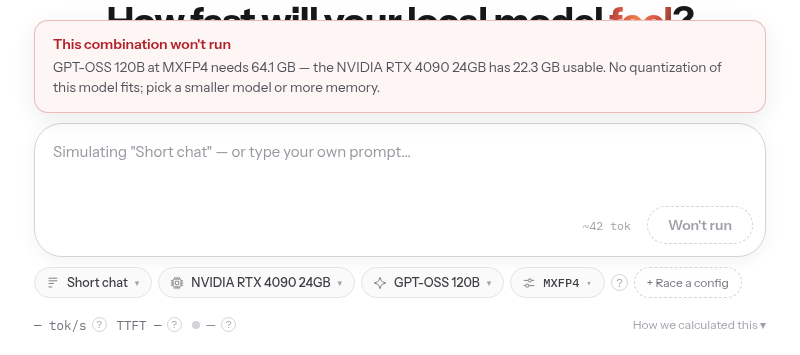
如果模型根本装不下,它会直接告诉你差多少。比如 GPT-OSS 120B 需要约 64GB,RTX 4090 只有 22.3GB 可用,所有量化版本都放不下:
它是怎么算的
README 里把方法写得很清楚,大致是三条:
- 出字速度看显存带宽。 每生成一个 token,模型的权重都要从显存里读一遍,所以带宽越高越快。MoE 模型(名字里带 A3B、A4B 的那种)每次只用一部分参数,只按「激活参数」算,所以一个 35B 的 MoE 模型可能比一个 9B 的普通模型还快。
- 首字等待看算力。 读你的提示词(预填)主要吃显卡的 FP16 算力,所以提示词很长时,N 卡比 Mac 快很多。
- 能不能装下:权重 + KV 缓存 + 运行开销,和可用内存比。它按 Mac 统一内存的约 75%、独立显卡显存的约 93% 算「可用」。装不下但差得不多时,按「一部分在显存、一部分在内存」估算,速度会掉一大截。
我整理的几组典型配置
下面的数字都是我按 llmspeed 的数据文件和它网页上的计算方法算出来的,和网页上显示的一致(我抽查了几组)。括号里是可信度标签,单位是每秒生成的 token 数,提示词为短问题。
表 1:出字速度(tok/s)
| 硬件 | Qwen 3.5 9B(Q4) | GPT-OSS 20B | Qwen 3.5/3.6 35B A3B(Q4) | GPT-OSS 120B |
|---|---|---|---|---|
| NVIDIA RTX 3060 12GB | 13–42(推算) | 27–89(估算),部分放内存 | 18–60(估算),部分放内存 | 放不下 |
| NVIDIA RTX 5060 Ti 16GB | 17–52(推算) | 45–142(推算) | 24–78(估算),部分放内存 | 放不下 |
| NVIDIA RTX 3090 24GB | 35–109(推算) | 94–297(推算) | 88–289(估算),部分放内存 | 放不下 |
| NVIDIA RTX 4090 24GB | 37–118(推算) | 101–320(推算) | 93–307(估算),部分放内存 | 放不下 |
| NVIDIA RTX 5090 32GB | 66–209(推算) | 180–569(推算) | 203–643(推算) | 14–47(估算),部分放内存 |
| MacBook M4 Pro 24GB | 15–37(推算) | 40–100(推算) | 放不下 | 放不下 |
| Mac mini M5 Pro 64GB | 16–41(推算) | 44–113(推算) | 50–127(推算) | 放不下 |
| MacBook Pro M5 Max 128GB | 33–83(推算) | 123–154(实测) | 84–105(实测) | 67–170(推算) |
| AMD Ryzen AI Max+ 395 128GB (Strix Halo) | 14–43(推算) | 64–83(实测) | 45–60(实测) | 45–58(实测) |
| CPU-only (Ryzen 9 9950X, 96GB DDR5) | 9.1–12(推算) | 25–33(推算) | 28–37(推算) | 19–25(推算) |
几个看点:
- 12GB 和 16GB 显卡:9B 左右的模型能流畅跑;GPT-OSS 20B 在 16GB 卡上刚好装得下,12GB 的 3060 就要分一部分到内存里了。
- 24GB 卡(3090 / 4090)跑 35B A3B 这类模型:Q4 量化约 22GB,加上缓存刚好超出一点,所以显示「部分放内存」。实际用的时候可以换更小的量化,或者把上下文开小一点。
- 大内存机器(M5 Max 128GB、Ryzen AI Max+ 395 128GB):单论速度不如顶级 N 卡,但能装下 GPT-OSS 120B 这种大模型。Ryzen AI Max+ 395 跑 GPT-OSS 120B 有实测数据,每秒 45–58 token,聊天够用。
- 纯 CPU:96GB 内存能装下很多模型,MoE 模型每秒二三十 token 还能用,普通 27B、31B 这类模型就很慢了。
表 2:首字等待时间(以 GPT-OSS 20B 为例)
| 硬件 | 短问题(约 42 token) | 一份代码文件(约 1800 token) | 20 页文档(约 12500 token) |
|---|---|---|---|
| NVIDIA RTX 3060 12GB | 1.2 秒 | 3.1 秒 | 14.3 秒 |
| NVIDIA RTX 5060 Ti 16GB | 0.3 秒 | 0.7 秒 | 3.3 秒 |
| NVIDIA RTX 3090 24GB | 0.3 秒 | 0.6 秒 | 2.3 秒 |
| NVIDIA RTX 4090 24GB | 0.3 秒 | 0.4 秒 | 1.2 秒 |
| NVIDIA RTX 5090 32GB | 0.3 秒 | 0.4 秒 | 1.0 秒 |
| MacBook M4 Pro 24GB | 0.4 秒 | 3.0 秒 | 21.6 秒 |
| Mac mini M5 Pro 64GB | 0.3 秒 | 1.6 秒 | 10.6 秒 |
| MacBook Pro M5 Max 128GB | 0.3 秒 | 1.0 秒 | 5.8 秒 |
| AMD Ryzen AI Max+ 395 128GB (Strix Halo) | 0.3 秒 | 1.2 秒 | 6.7 秒 |
| CPU-only (Ryzen 9 9950X, 96GB DDR5) | 0.4 秒 | 3.9 秒 | 29.1 秒 |
这张表是我觉得最该看的。短问题大家都差不多,但丢一份 20 页文档进去,4090 一秒多就开始回答,M4 Pro 的 MacBook 要等 20 多秒,纯 CPU 要等半分钟左右。如果你打算让本地模型读长文档、读代码仓库、给编程 Agent 当后端,首字等待比出字速度更影响体验。
局限和要注意的地方
- 只算单设备。 多卡并联(张量并行、分层切分)还不支持。
- 是估算,不是保证。 README 自己写了:驱动、引擎版本、Flash Attention、功耗限制、散热都可能让实际速度差 10%–30%。社区实测的测试条件也不统一,同一张表里偶尔会有看起来反常的数字,比如 RTX 5090 跑 Llama 3.1 8B 的实测反而比 4090 低,看到这种情况多参考几组数据。
- 模型和硬件不全。 15 个模型主要是 Qwen、Gemma、GPT-OSS、GLM、DeepSeek 这几家;很多常见的笔记本显卡(比如 RTX 4060 笔记本版)没收录。
- 界面只有英文。 好在操作很简单,几个下拉框而已。
- 只管速度,不管效果。 跑得快不代表回答得好,小模型的质量还是要自己试。
你也可以贡献实测数据
如果你手上有显卡,可以用 llama.cpp 自带的测试工具跑一下,再把结果提交到仓库的 benchmarks/submissions.csv:
llama-bench -m 你的模型.gguf -p 512 -n 128
tg128 那一项是出字速度,pp512 是预填速度。按 README 的表格填好硬件、模型、量化、后端、引擎版本、来源链接,发 PR 时把完整输出贴进描述里。MLX、vLLM 等其他引擎的结果也收。
什么时候该用它
- 准备买显卡或 Mac 跑本地模型的:先把你想用的模型和预算内的几款硬件挨个试一遍,再用赛跑模式对比。
- 已经有硬件、想挑模型的:看哪些模型和量化版本能装进你的显存,速度能不能接受。
- 想跑超大模型的:先确认「装不装得下」。像我们写过的 AirLLM,靠分层加载能在小显存上把大模型跑起来,但速度慢到不适合聊天;Strata 把门槛抬到 12GB 以上显存加大内存,换来能用的速度。10 月 17 日刚更新的 DeepSeek V4.1 Flash 1017 这类模型,量化后还有几百 GB,在 llmspeed 里连 RTX 5090 都显示放不下。
算下来如果发现要花大几千甚至上万才能跑得舒服,而你只是日常聊天、写东西,不如先用各家的免费额度,见 2026 免费用 AI 完全指南。
另外,如果你买显卡不只是为了跑大模型聊天,也想在本地画图,显存的门槛会不太一样:比如 FLUX 3 Klein 的 INT8 版官方说 8GB N 卡就能跑,具体可以看 FLUX 3 Klein 本地 AI 画图上手。
相关链接
- 网站:llmspeed.dev
- GitHub:nicorobinreal/llmspeed
- 数据来源之一:localscore.ai


