
“4GB 显存跑 70B 大模型”“单卡跑 2.8T 的 Kimi K3”,AirLLM 的这些标题最近又在 GitHub 热门上刷屏了。我看到的第一反应是:这么好的事,代价在哪?查完资料,答案很明确:能跑,但非常慢。这篇把它的原理、能做什么和真实代价都讲清楚,免得大家被标题骗了。
资料来自 GitHub 仓库 README 和 issue 区的用户反馈,于 2026 年 10 月 13 日查阅。我自己没有实测,文中的显存数字都是作者在 README 里给出的。
AirLLM 是什么
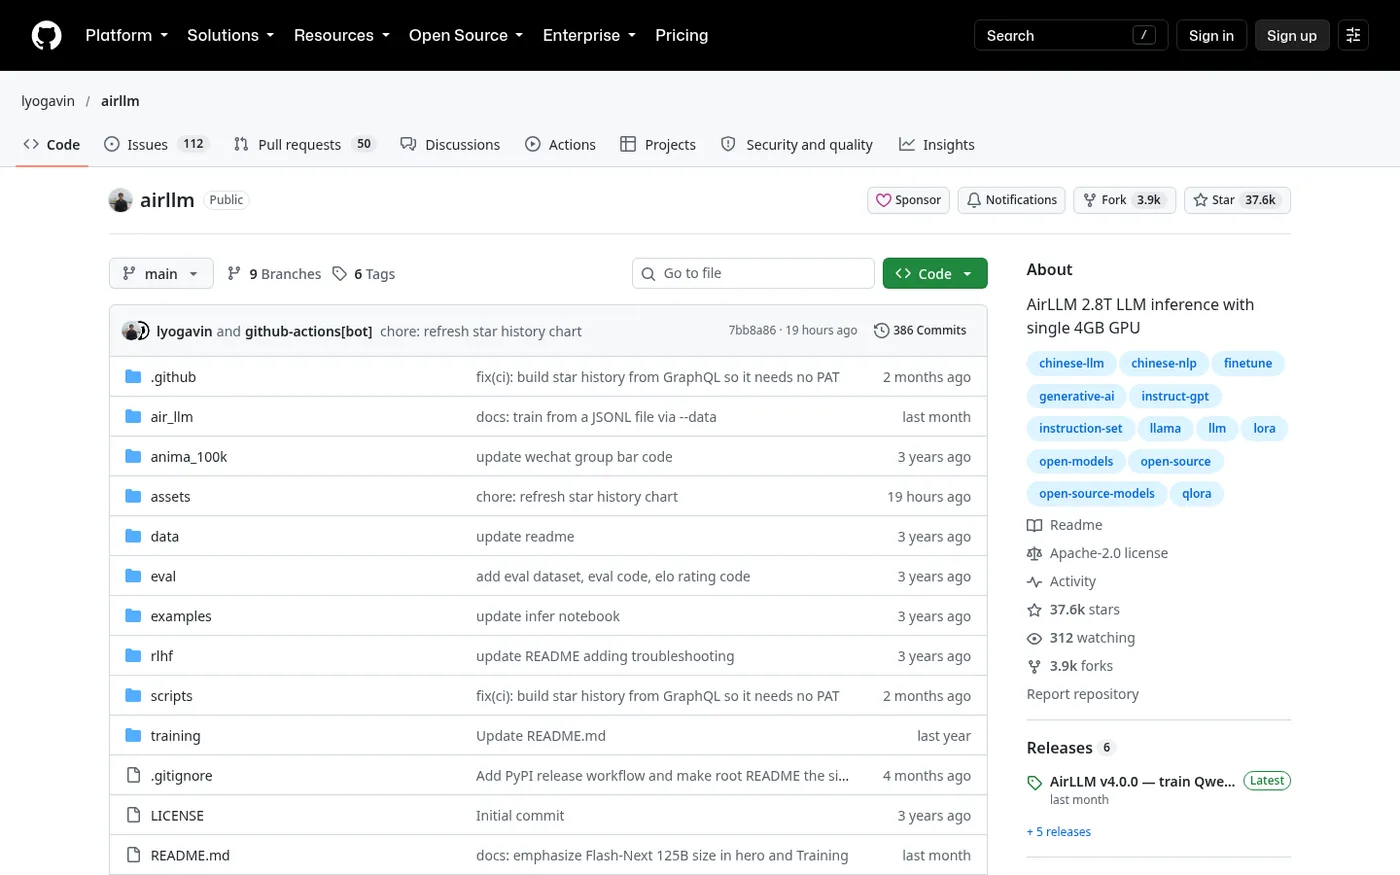
AirLLM 是作者 lyogavin 开源的大模型推理库,Apache-2.0 协议,写这篇时 GitHub 约 3.76 万颗星。它是一个 Python 包,用 pip install airllm 安装,然后在代码里加载 Hugging Face 上的模型。
它不是一个聊天软件,没有图形界面,需要写几行 Python 代码才能用。
它为什么能用这么少的显存
原理其实很简单:普通方式是把整个模型一次性装进显存,AirLLM 是一次只把一层放进 GPU。算完这一层,扔掉,再从硬盘读下一层。所以需要的显存取决于“单层有多大”,而不是模型总共多大。
README 给的显存数字(作者实测或估算):
| 模型 | 显存 |
|---|---|
| 约 8B 的模型(Qwen3、Mistral 等) | 约 1–2 GB |
| Llama 3.x 70B(不量化) | 约 4 GB |
| Qwen3-235B(MoE) | 约 3 GB |
| DeepSeek-V3 671B | 约 12 GB |
| Kimi K3 2.8T | 3.72 GB(RTX 6000 Ada 上测) |
代价:慢,非常慢
这是推荐文章最容易略过的部分。既然每一层都要从硬盘重新读进显存,那么每生成一个字,就要把整个模型从硬盘过一遍。70B 的模型有一百多 GB,速度瓶颈就落在硬盘读取上,README 自己也说瓶颈主要在磁盘加载。
README 首页没有给出每秒能生成多少个 token。我去翻了 issue 区,看到用户反馈的情况是这样的(这是个人报告,环境不同结果会差很多):
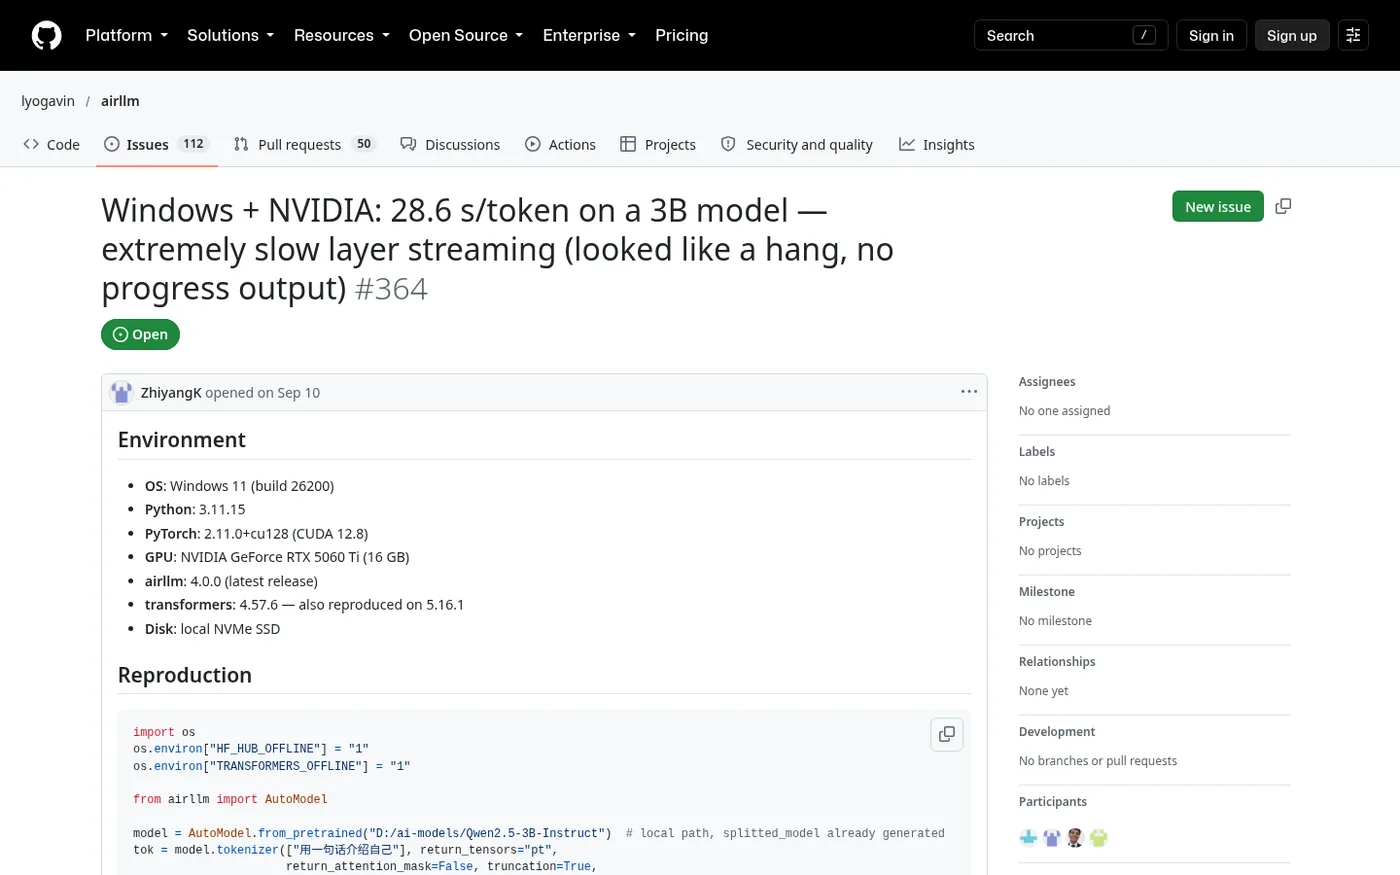
- 一位用户在 Windows 11、RTX 5060 Ti 16GB、NVMe 固态上跑 3B 小模型,报告约 28.6 秒生成一个 token(issue #364)。
- 另一位用户跑 GPT-OSS 20B,回答一个约 120 个 token 的问题用了 大约 30 分钟(issue #374)。
- 还有人在 AMD 显卡的 Windows 上用,反馈很慢、像是没用上 GPU(issue #301)。
这些 issue 写这篇时都还开着。所以我的结论是:AirLLM 能证明“小显存也能把大模型跑起来”,但它不适合聊天、写作这类需要即时回复的场景。
README 提到可以开启 4bit/8bit 压缩,作者称最多提速 3 倍、精度损失很小,但这是在一个很慢的基数上提速。
安装和使用
前提:有一张 NVIDIA 显卡(示例代码用的是 .cuda()),或者 Apple 芯片的 Mac(需要额外装 mlx 和 torch,Intel Mac 不支持)。2024 年的版本加入了 CPU 推理支持。
- 安装:
pip install airllm
- 加载模型并生成,核心就是这一句:
from airllm import AutoModel
model = AutoModel.from_pretrained("Qwen/Qwen3-32B")
后面用 tokenizer 编码输入、调用 model.generate(),和普通的 transformers 用法差不多,完整示例在 README 里。
几个注意点:
- 硬盘空间要大:第一次运行会把原模型拆成一层一层存下来,非常占空间。README 的常见问题第一条就是硬盘满了导致的报错。可以设置
delete_original=True删掉原始下载文件,省一半空间。 - 硬盘要快:既然瓶颈在读盘,机械硬盘基本没法用,至少要 NVMe 固态。
- 国内下载模型:模型来自 Hugging Face,国内可能需要配置镜像。
- 新模型(比如 Qwen3.8 系列、Kimi K3)还有额外依赖,要按 README 装指定版本的 transformers 等。
优点
- 思路巧妙,真能让几 GB 显存的卡加载上百 B 的模型。
- 用法简单,一个
AutoModel支持 Llama、Qwen、DeepSeek、Mistral、Gemma、ChatGLM 等主流模型。 - 开源免费,2026 年 9 月还加了在小显存上微调大模型的功能。
- 项目一直在更新,跟进新模型很快。
不足
- 速度慢到不适合日常对话,用户报告的数字是“秒级一个 token”甚至“半小时一个回答”。
- 极度吃硬盘空间和读写速度。
- 没有图形界面,要会写 Python。
- README 里的显存数字是作者给的,不同环境可能有出入。
- README 开头还夹着几条和项目无关的 AI 产品推荐链接,看着有点乱。
适合谁
- 想研究“大模型能不能在小显卡上跑起来”的开发者和学生。
- 能接受慢、只是偶尔跑一次离线批处理任务的人,比如丢一堆问题让它跑一整晚。
- 想在消费级显卡上试试微调大模型的人。
如果你只是想在自己电脑上流畅地和本地大模型聊天,我更建议选一个适合自己显存的小模型(比如 7B、14B 量化版),用 Ollama 之类的工具跑,体验会好得多。


