
这两年本地 AI 画图,我一直卡在同一个地方:好模型要么显存吃得太狠,要么只能在网上用、按张收费。10 月 15 日 Black Forest Labs(就是做 FLUX 系列的那家德国公司)放出 FLUX 3 Image Klein,官方给的几个数字正好戳在这个痛点上:图像模型 5.6B 参数,原生出 4K 图,用 INT8 版本时 8GB 显存的 N 卡就能跑。
我花了一个周末把官方博客、Hugging Face 模型卡、ComfyUI 文档和许可证原文都读了一遍,整理成这篇上手笔记。先说清楚:我手边这台机器没有 N 卡,没法自己跑测速,所以下面的显存、速度数字都来自官方,每个都标了出处。装法和参数按 ComfyUI 官方文档走,一步步照着做就能用。
资料核对时间:2026 年 10 月 19 日(北京时间)。ComfyUI 当前最新版是 v0.42.1。
先说结论
- 值得装:如果你有一张 8GB 以上的 NVIDIA 显卡,又想在自己电脑上画图、改图,这是目前门槛最低的一档好模型之一。
- 一定要开「提示词扩写」:官方反复强调这个模型吃的是完整的场景描述,直接丢一句短提示词进去,出来的图会很平庸。
- 商用要看营收:个人和年营收低于 500 万美元的公司可以把生成的图拿去商用,但许可证还附带了内容审核和 AI 标注的条件,不是「随便用」。
- 画国画能用,但别指望一步到位:落款、题字、印章最好后期自己加,打印要提前算好分辨率。
它到底新在哪
FLUX 3 Image Klein 是 FLUX 3 家族里第二个开放权重的模型(第一个是 FLUX 3 Action)。一个模型同时管三件事:
- 文生图:输入一段描述,出一张图。
- 改图:给一张图,用文字说要改成什么样。
- 多图参考:最多喂 10 张参考图,把里面的人物、物件、风格组合到一张新图里。
另外还有两个比较少见的能力:
- 边框控制布局:在提示词里用 0–1000 的坐标框住某个区域,告诉模型这里放什么,或者只改这个区域。模型卡也说了,框只管位置和大小,不是硬遮罩,元素还是可能跑出框外。
- 原生 4K:BFL 文档写的最大分辨率是「Up to 4K」,Comfy 官方页面说它是直接生成 4K,不是先出小图再放大。
它分两个版本:
| 版本 | 采样步数 | 引导系数(CFG) | 适合 |
|---|---|---|---|
| Klein(蒸馏版) | 16 步 | 无(ComfyUI 里固定为 1) | 日常出图、改图,BFL API 背后用的就是它 |
| Klein Base(基础版) | 50 步 | 3.5 | 训练 LoRA、微调、研究 |
文本编码器用的是 Qwen3-VL-4B-Instruct(Apache-2.0 协议)。要注意的是,5.6B 这个参数量只算图像生成部分,文本编码器另算,所以实际占用比 5.6B 听起来大。
好的地方和不够好的地方
我觉得好的:
- 小:官方拿来对比的开放模型里它参数最少,Qwen-Image 2.1 是 7B,Krea 2 是 12.9B。BFL 自己的内部评测里,它比上一代 FLUX.2 [klein] 9B 少了 38% 参数,文生图的 Elo 分反而高了 91(这是厂商自测,看个方向就好)。
- 快:NVIDIA 实测,用蒸馏版加 INT8,在 ComfyUI 里出一张 100 万像素的图,RTX 4070 不到 9 秒,RTX 5090 大约 4 秒。
- 一套模型全包:文生图、改图、多图参考都用同一套权重,不用为改图再下一个模型。
- ComfyUI 首发就支持:发布当天 ComfyUI v0.41.0 就原生支持了,还自带现成的工作流模板。
不够好的:
- 离不开提示词扩写:扩写用的是另一个 9B 模型,又多一份下载和显存开销。不想用它,就得自己用别的大模型写好完整的英文描述。
- 权重要申请:Hugging Face 上是 gated 仓库,要登录并同意许可证才能下载。
- 官方说法不完全一致:博客说 INT8 版 8GB 显存能跑,BFL 文档的概述却写「down to an RTX 3090」(24GB)。我的理解是两者说的配置不同:8GB 指 INT8 量化版跑 ComfyUI 或 Diffusers,3090 那句更像是不量化的情况。显存小的话就老老实实用 INT8。
- 文字渲染不可靠:模型卡明说生成的文字可能不准或变形。模型卡标注的语言也只有英文,中文提示词效果怎么样我没有核实到。
- 只看到 N 卡的数据:官方的量化版和测速全是 NVIDIA 显卡,Mac 和 AMD 能不能跑、跑得怎么样,我没找到官方说明。
我的显卡能跑吗
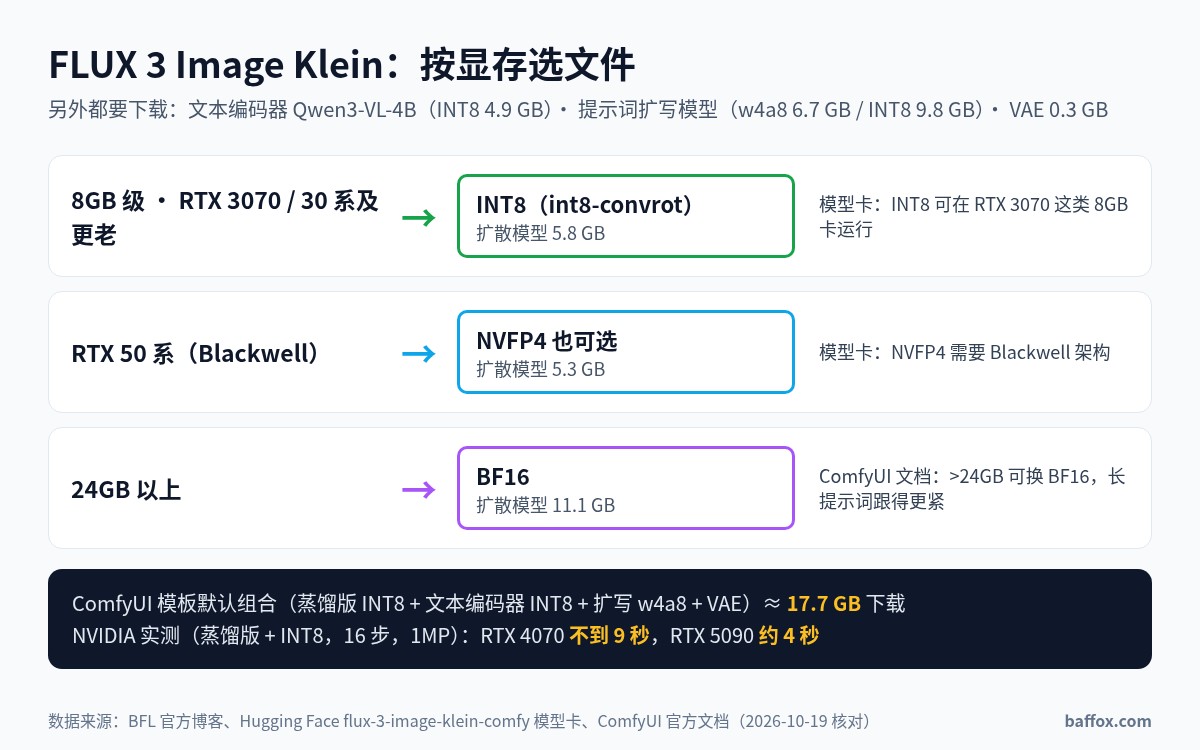
ComfyUI 版的模型文件放在 black-forest-labs/flux-3-image-klein-comfy 这个仓库里。按显存挑文件,大致是这样:
| 你的显卡 | 建议用的文件 | 官方依据 |
|---|---|---|
| 8GB 级,比如 RTX 3070,以及 RTX 30 系和更老的卡 | INT8(int8-convrot) |
模型卡:INT8 能跑在 RTX 3070 这类 8GB 显卡上,也适合不支持 FP8 的 30 系及更老的卡 |
| RTX 50 系(Blackwell) | 也可以试 NVFP4 | 模型卡:NVFP4 需要 Blackwell 架构 |
| 24GB 以上 | BF16 | ComfyUI 文档:显存超过 24GB 可以换 BF16 版,长提示词跟得更紧 |
几个文件的大小(摘自模型卡):
| 文件 | 内容 | 大小 |
|---|---|---|
flux3-image-klein-int8-convrot.safetensors |
蒸馏版,INT8 | 5.8 GB |
flux3-image-klein-bf16.safetensors |
蒸馏版,BF16 | 11.1 GB |
qwen3vl_4b_int8_convrot.safetensors |
文本编码器,INT8 | 4.9 GB |
qwen3.5_9b_flux3_prompt_upsampler_w4a8.safetensors |
提示词扩写模型,w4a8 | 6.7 GB |
flux2-vae.safetensors |
VAE | 0.3 GB |
按 ComfyUI 模板默认的组合(蒸馏版 INT8、文本编码器 INT8、扩写模型 w4a8、VAE),我算了一下要下载大约 17.7 GB。再加一个基础版 INT8,就是 23.5 GB 左右,硬盘留 30GB 比较稳。
有一点要心里有数:8GB 卡跑生成没问题,但扩写模型本身也有 6.7GB,两个能不能都顺畅跑在 8GB 卡上,我没找到官方实测。如果发现卡顿或者爆显存,可以先关掉扩写,换成用 DeepSeek、Kimi 这类在线大模型把描述写好,再贴进去。
模型卡还给过一组参考数据:用 BFL 自己的推理代码,在数据中心卡 B200 上出 1024×1024 的图、不开扩写,峰值显存 BF16 是 31GB,FP8 是 26GB。这是官方参考代码的数字,不是 ComfyUI 的。ComfyUI 会自己调度显存,所以普通显卡请用 INT8 版加 ComfyUI,别照着这个数字去配卡。
如果你还在纠结要不要为本地 AI 买显卡,可以先看看我之前写的 llmspeed 显卡速度表,那篇说的是大模型对话,但选显存的思路是一样的。
装起来:五步
第 1 步:装好或升级 ComfyUI
还没装的话,去 ComfyUI 官网下载页 下桌面版,Windows 用户最省事。已经装了的,按 官方升级指南 升到最新版。
官方文档写的最低版本是 0.41.0。但发布后官方又修过几次工作流模板,ComfyUI 也连发了好几个小版本。我的建议是直接升到当前最新版。
第 2 步:在 Hugging Face 同意许可证
登录 Hugging Face,打开 flux-3-image-klein-comfy 仓库页面,按提示同意 FLUX Kommunity License,才能下载文件。点同意之前,建议先读完下面「能不能商用」那一节。
第 3 步:下载模型文件
可以在网页上一个个点下载,也可以用模型卡给的命令一次下好。下面是模型卡原文的命令,它下的是 INT8 版的扩写模型(9.8 GB)。想省空间,可以把最后一个文件换成 text_encoders/qwen3.5_9b_flux3_prompt_upsampler_w4a8.safetensors:
hf download black-forest-labs/flux-3-image-klein-comfy \
  diffusion_models/flux3-image-klein-int8-convrot.safetensors \
  text_encoders/qwen3vl_4b_int8_convrot.safetensors \
  vae/flux2-vae.safetensors \
  text_encoders/qwen3.5_9b_flux3_prompt_upsampler_int8_convrot.safetensors \
  --local-dir ComfyUI/models
hf 是 Hugging Face 的命令行工具,用 pip install -U huggingface_hub 安装,装好后先运行 hf auth login 登录。国内下载慢的话,就用浏览器分几次下,下完放进对应的文件夹。
第 4 步:把文件放对位置
ComfyUI/models/
├── diffusion_models/   ← flux3-image-klein-int8-convrot.safetensors
├── text_encoders/      ← qwen3vl_4b_int8_convrot.safetensors
│                         qwen3.5_9b_flux3_prompt_upsampler_*.safetensors
└── vae/                ← flux2-vae.safetensors
如果你自己搭工作流:模型用 Load Diffusion Model 节点加载,文本编码器用 Load CLIP 节点并把 type 选成 flux3,VAE 用 Load VAE 节点。
第 5 步:打开官方模板
在 ComfyUI 的模板库(Template Library)里搜 「FLUX 3 Image Klein Distilled: Text to Image」,从模板库重新打开。不要用发布当天存下来的旧工作流:发布没两天,BFL 就把 Hugging Face 仓库里的旧模板整套换掉了,新模板每个都内置了提示词扩写。
第一张图:参数怎么调
打开蒸馏版的文生图模板之后,基本只用动这几处:
- 提示词:模板默认开了扩写,写一句简单描述就行,它会先扩写成完整描述再出图。
- 步数:4 到 16 之间,默认 16。想先快速试构图就降到 8 左右,定稿再调回 16。
- CFG:蒸馏版固定为 1,调高也没用。
- 尺寸:在 ResolutionSelector 里选画幅,默认是 1:1 方图。试构图时先用 1024 左右的小尺寸,速度快;定稿再往上调。
- 点 Queue,图会保存到
ComfyUI/output/。
想改图就换成「Image Edit」模板:把原图接到 Set Reference Multi Latent 节点上,提示词里用 <ref_image_0> 指代第一张参考图。官方有一条提示很实用:写你要的结果,而不是写怎么改。与其写「把裙子改成红色」,不如把改完之后的整个画面描述一遍。
用基础版(Base)就是 50 步、CFG 3.5,速度慢不少,除非要训练 LoRA,日常出图用蒸馏版就够了。
拿它画国画:我的思路
最近有朋友问我能不能批量出青绿山水、工笔花鸟这类国画图。Klein 有两点正好适合:一是能直接出高分辨率,二是能用参考图锁住风格。我的做法是这样的:
1. 用画法和材质描述风格,别写画家名字。 模型卡在提示词建议里专门说了,描述风格时写色彩、笔触、质感,而不是点名某件作品。这样做效果更可控,也能避开模仿特定画家作品的版权麻烦。我常用的描述方向:
- 青绿山水:
traditional Chinese blue-green landscape painting on aged silk, mineral azurite and malachite pigments, fine ink outlines, layered mountains, mist between peaks, red maple trees, a small waterfall, vertical hanging scroll composition - 水墨写意:
Chinese ink wash painting on rice paper, wet ink bleeding into the paper fibers, varied ink tones from pale grey to deep black, generous empty space, loose expressive brushwork - 工笔花鸟:
gongbi style Chinese painting, peony and a small bird, extremely fine even outlines, layered transparent color washes, light cream silk background, square composition
2. 不要让它写字。 题款、落款、印章最好在提示词里写明 no text, no calligraphy, no seal,后期再自己加,或者请书法好的朋友写。AI 生成的汉字很容易缺笔画、写错字,放在国画上特别扎眼。
3. 风格要统一时,用参考图。 先挑一张满意的图当参考图,用改图模板接进去,再换题材描述。客户要一整套风格接近的图时,这比每次重写提示词稳定得多。
4. 打印前先算分辨率。 按印刷常用的 300 dpi 算,打印尺寸(厘米)= 像素 ÷ 300 × 2.54:
| 长边像素 | 300 dpi 可印长边 | 150 dpi 可印长边 |
|---|---|---|
| 2048 | 约 17 cm | 约 35 cm |
| 4096(按 4K 级估算) | 约 35 cm | 约 69 cm |
| 8192(4K 再放大 2 倍) | 约 69 cm | 约 139 cm |
斗方、小品直接出 4K 基本够用。要印成一米多的竖轴,就得在 ComfyUI 里再接一步放大:用 Load Upscale Model 加 Upscale Image (using Model) 两个节点,放大模型文件放进 ComfyUI/models/upscale_models/。选放大模型时要看它自己的许可证是否允许商用。放大之后一定要按 100% 比例逐块检查,AI 图最容易在树叶、水纹、远山这些细节上糊成一片。
5. 小图满意,大图还能一样吗? 固定种子(seed)和提示词,只把分辨率调大,构图往往会变,因为分辨率本身也会影响生成结果。最稳的做法是选定小图后直接放大这一张,而不是用同样的提示词重新生成一张大图。
如果需要正版免费的字体、印章素材来做后期,可以翻翻我整理的 正版免费资源合集。
能不能商用:许可证读下来的要点
我把 FLUX Kommunity License v1.0 原文读了一遍,跟普通用户关系最大的是这几条(以下是我的理解,不构成法律意见):
- 非商业用途免费:个人学习、研究、自娱自乐都行。
- 符合条件的用户可以商用生成的图:许可证把「Qualifying User」定义为你和关联公司的年化总营收低于 500 万美元(US$5,000,000)。符合条件的话,可以把生成的图用于商业用途,也可以为了生成这些图在生产环境里运行模型。
- 商用附带条件(第 2.e 条):要么做内容过滤,防止生成违法或侵权内容;要么在发布前人工审核生成的图。另外,当地法律要求标注 AI 生成的,就必须标注。
- 商用的只是「生成的图」:用于商业目的的微调、分发模型这类用途不在免费范围内。模型卡说得很直接,这个商用例外不等于可以商业微调或分发。需要的话去 BFL 商业授权页 申请。
- 明确禁止:军事、监控、生物特征识别、侵犯他人肖像权等权利、生成违法内容,以及用它的输出去训练同类竞品模型。
给客户出图收费属于商用。如果你是个人或小工作室,营收远低于门槛,按许可证是可以的,记得自己审一遍图,该标 AI 生成的地方标上。
常见问题
没有显卡能用吗?
能,只是不是本地跑了。BFL 官方 API 的模型名是 flux-3-image-klein,按出图分辨率收费,1K 一张 0.009 美元,4K 一张 0.036 美元。Hugging Face 上也有官方的 在线试用页,想先看看效果可以去试试。
Mac 能跑吗?
官方的量化版本和测速都是 NVIDIA 显卡,我没找到 Mac 或 AMD 显卡的官方支持说明,这里就不乱猜了。
和 Stable Diffusion 那些老模型比,要不要换?
如果你手上已经有一套调好的 SD 工作流和 LoRA,不用急着全部换掉。Klein 的长处是同一个模型就能出图、改图、多图参考,而且能出原生 4K,新项目可以先拿它试。
能训练自己的 LoRA 吗?
可以,用基础版(Base)。Diffusers 和 Ostris 的 AI Toolkit 首发就支持 LoRA 训练。注意按许可证,为商用目的微调需要另外申请授权。
提示词能写中文吗?
模型卡标注的语言只有英文。扩写模型能不能把中文描述扩写好,我没有核实到。稳妥起见,直接写英文,或者先让大模型帮你翻成完整的英文场景描述。
本地跑 AI 不只是画图。如果你对显存不够也想跑大模型感兴趣,可以看看 AirLLM 这篇;想把电子书在本机转成有声书的,可以看 Folivox。


