


让 Claude Code 或 Codex 接手一个陌生项目,最费 token 的往往不是写代码,而是“找代码”:它要一遍遍 grep、打开文件、读几百行,才搞清楚某个类在哪定义、被谁调用、改了会影响哪里。项目一大,上下文窗口很快就被这些探路的输出塞满。
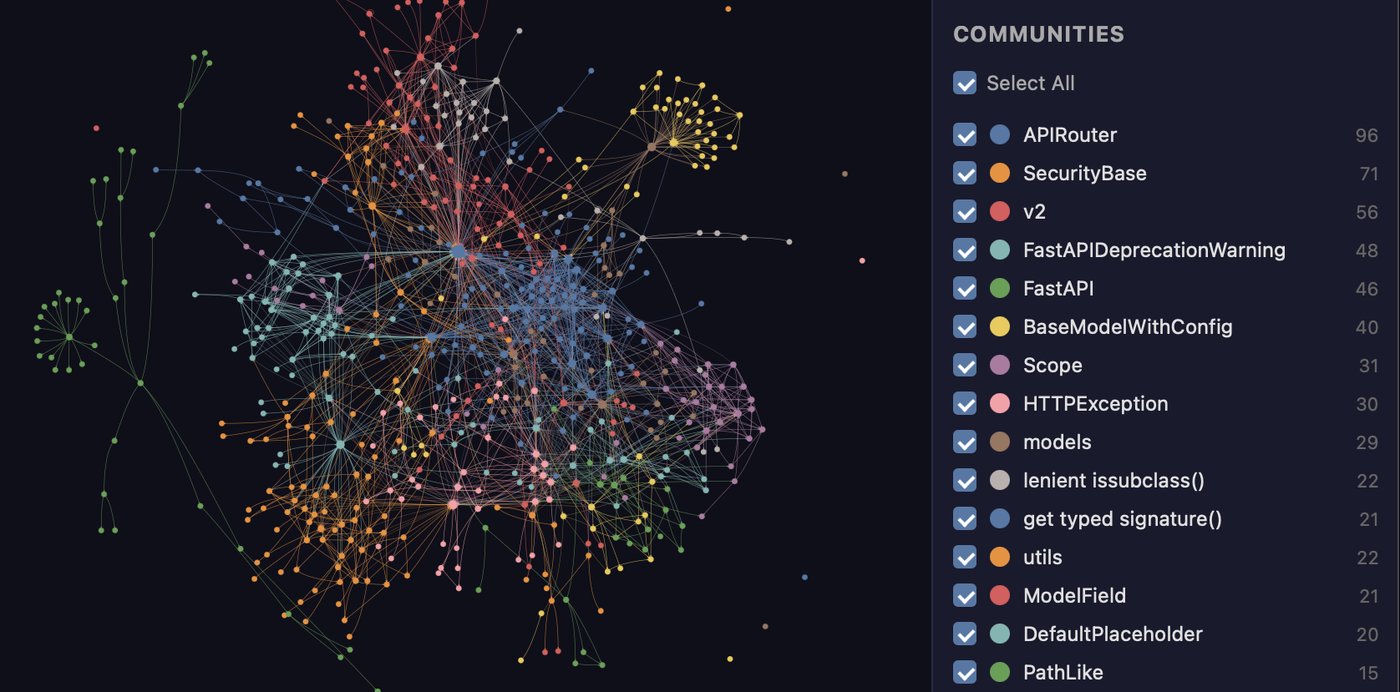
Graphify 换了个思路:先把整个项目解析成一张知识图谱,类、函数、文件、文档标题都是节点,调用、导入、继承这些关系都是边;之后 AI 要问“这个类和那个模块怎么连起来的”,直接查图,不用再翻文件。它以技能(Skill)的形式装进 Claude Code、Codex、Cursor、Gemini CLI 等 20 多种编程助手,在对话里输入 /graphify . 就能用。
项目在 GitHub 上约 13.2 万星,Apache-2.0 协议,这几天每天还在涨一千多星。我们在 Linux 上装了 PyPI 的 0.9.93 版(10 月 21 日凌晨发布,北京时间),拿本站介绍过的 Python 爬虫库 Scrapling 的源码实测了一遍。资料查阅于 2026-10-22。
基本信息
| 项目 | 情况 |
|---|---|
| 开发方 | Graphify Labs(YC S26 孵化),GitHub 仓库 Graphify-Labs/graphify |
| 许可证 | Apache-2.0,开源引擎免费;另有收费的 Graphify Cloud,14 天免费试用 |
| 版本 | 0.9.93(2026 年 10 月 21 日发布) |
| 安装 | Python 3.10+,PyPI 包名是 graphifyy(两个 y),命令仍是 graphify |
| 支持的助手 | Claude Code、Codex、Cursor、Gemini CLI、GitHub Copilot、OpenCode、Kimi Code、Trae / Trae CN、Aider 等 20 多种 |
| 能解析的内容 | 约 40 种编程语言(tree-sitter 语法树),外加 Markdown、PDF、图片、音视频 |
| 输出 | graph.html(可点击的图)、GRAPH_REPORT.md(要点报告)、graph.json(完整图谱) |
最关键的一点:代码部分完全在本机解析,不调用大模型,也不花 token。只有文档、PDF、图片这类非代码内容,才需要借助你助手里的模型(或你配置的 API Key)做一遍语义提取。
安装:两条命令
官方推荐用 uv 或 pipx 装成独立的命令行工具:
uv tool install graphifyy      # 或者:pipx install graphifyy
graphify install               # 自动识别你在用的助手,注册技能
注意包名是 graphifyy。官方 README 特意提醒,PyPI 上其他叫 graphify 的包都和他们无关,装错了可能装到别人的东西,这在供应链投毒频发的当下要格外留意。
graphify install 默认装给 Claude Code。用别的助手要加 --platform,例如 Codex 用 graphify install --platform codex、Trae 国内版用 --platform trae-cn、Kimi Code 用 --platform kimi;Cursor 用的是 graphify cursor install。想只装到当前项目、方便团队一起用,就加 --project。
我们在一个空 Git 仓库里试了 graphify install --project --platform codex,它做了三件事:
- 在
.codex/skills/graphify/下放了技能说明SKILL.md和 8 个按需加载的参考文档; - 在项目根目录的
AGENTS.md里追加了一段说明,让 Codex 回答代码问题前先查图谱; - 在
.codex/hooks.json里注册了一个钩子。
装好后,Claude Code 里输入 /graphify .,Codex 里输入 $graphify .(Codex 用 $ 不用 /)。官方还提醒,Codex 要在 ~/.codex/config.toml 的 [features] 下打开 multi_agent = true,才能并行提取。
实测:Scrapling 源码,8 秒出图
不想在助手里跑,也可以直接用命令行建图。graphify update 只处理代码,不需要任何 API Key:
cd Scrapling
graphify update .
graphify god-nodes --top 5           # 列出连接最多的“枢纽”节点
graphify explain "StealthyFetcher"   # 解释一个节点:在哪定义、和谁有关
graphify query "how does the spider rotate proxies" --budget 500
Scrapling 仓库一共 585 个文件,Graphify 用 8 个线程做语法树解析,约 8 秒就建好了图:11073 个节点、22001 条边、760 个社区(自动聚类出来的子系统),报告里写着 Token cost: 0 input · 0 output。
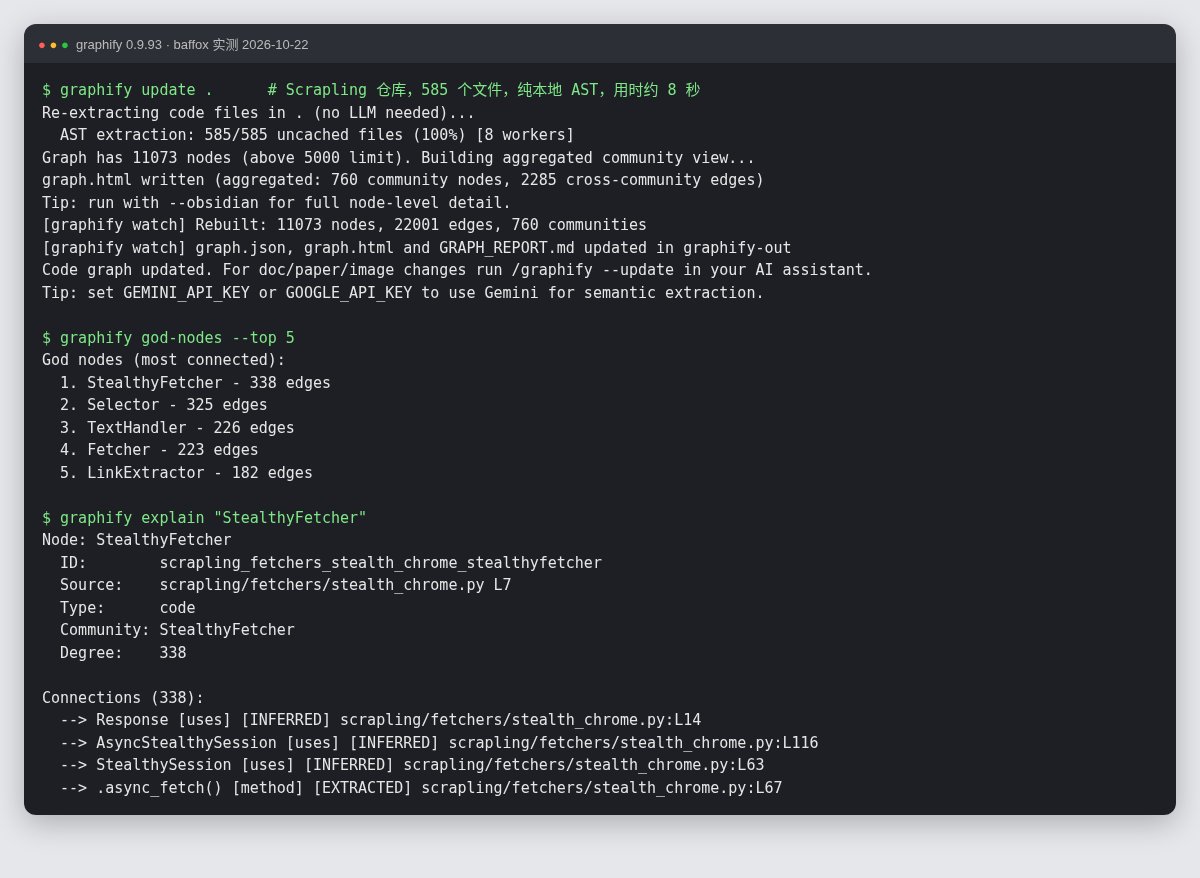
几个命令的实际效果:
- god-nodes:排在前面的是
StealthyFetcher、Selector、TextHandler、Fetcher、LinkExtractor,和我们之前写 Scrapling 上手实测 时对这个库的理解基本一致:抓取器和选择器就是它的两根主干。 - explain:会给出定义位置(
scrapling/fetchers/stealth_chrome.py第 7 行)、所属社区和每一条关系。每条边都标着EXTRACTED(源码里明写的,比如继承、导入)或INFERRED(Graphify 推断的,比如“用到了”),能分清哪些是事实、哪些是推测。 - query:用一句英文问题从相关节点出发做广度遍历,
--budget控制返回内容的 token 上限,超出时会明确告诉你“截掉了多少个节点,要看全请把预算调到多少”。这正是给 AI 用的设计:先给一份小而准的子图,不够再要。 - path:查两个东西之间的最短关系链。重名时它不会乱猜,会列出候选让你用
文件路径::名字或完整 ID 重试。
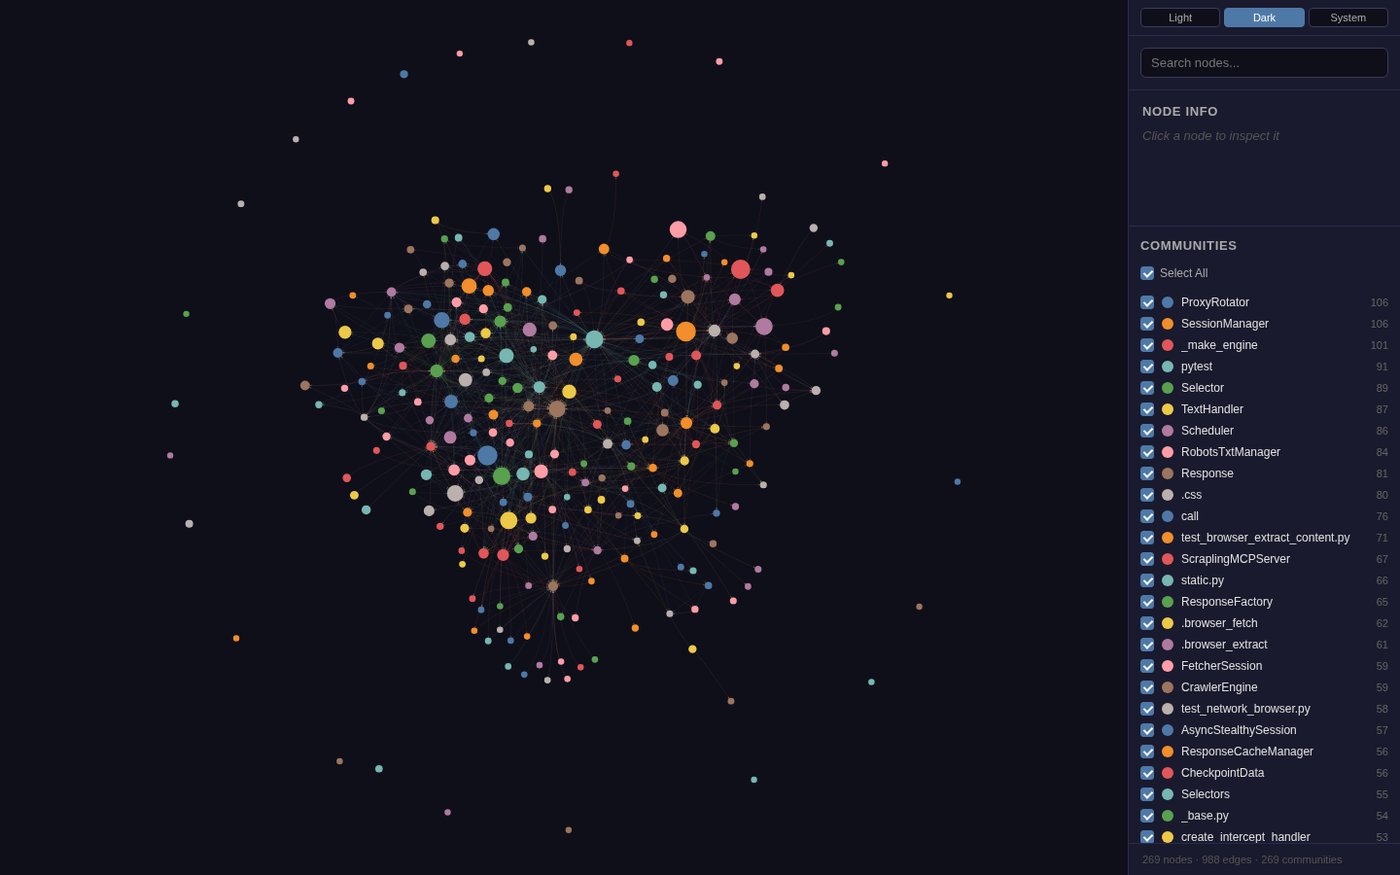
graph.html 用浏览器打开就是一张能拖、能搜、能按社区筛选的图。节点超过 5000 个时,它会自动改成“按社区聚合”的视图,避免浏览器卡死。
一个实用技巧:用 .graphifyignore 去掉噪音
第一次跑完我们发现,StealthyFetcher 有 338 条关系,其中一大堆来自 docs/locales/ 下阿拉伯语、德语、西班牙语等十几种翻译文档。对 AI 理解代码来说,这些全是重复的噪音。
Graphify 支持在项目根目录放一个 .graphifyignore,写法和 .gitignore 一样。我们加了两行:
docs/locales/
docs/README_*.md
重新建图后,文件数从 585 降到 234,节点从 11073 降到 5457,StealthyFetcher 的关系从 338 条降到 50 条,都是真正跟代码相关的。大项目第一次用,建议先看一眼报告里哪些目录贡献了最多节点,把翻译文档、示例数据、打包产物排除掉,图会干净很多,AI 查询时也更省 token。
和其他“省上下文”工具怎么配合
Graphify 解决的是“AI 找代码太费劲”,和本站介绍过的几类工具分工不同:
- Context Mode 管的是工具输出太长,把命令结果压缩后再交给模型;Graphify 管的是一开始就少读文件。两个可以一起装。
- ai-memory 记的是“这个项目做过什么决定、做到哪了”,属于工作记忆;Graphify 记的是“代码长什么样”,属于结构地图。
- 想多装几个技能的,可以看 5 个热门 AI 编程技能包合集,Graphify 也是同一类 Agent Skill。
还有几个进阶用法:graphify hook install 装 Git 钩子,每次提交后自动重建图谱;graphify watch . 在后台盯着代码变化实时更新;在助手里用 /graphify . --mcp 可以把图谱作为 MCP 服务提供给别的客户端;graphify export obsidian 能导出成 Obsidian 笔记库。
使用前要知道的几件事
- 官方的数字要理性看。 README 首页写着“token 花费减少 80%”,那是收费的 Graphify Cloud 的宣传语;仓库里的基准测试(LOCOMO、LongMemEval 等)也是项目方自己跑的。实际能省多少,取决于项目大小,几十个文件的小项目本来就能整个塞进上下文,图谱的价值主要在于理清结构。
- 非代码内容会调用模型。 对文档、PDF、图片做语义提取,会用你助手的模型或你配置的 Key,这部分要花 token,内容也会发给对应的模型服务。公司的敏感文档要先想好。
- 图谱会过期。 改了代码不重建,AI 查到的就是旧结构。报告里会记录建图时的 commit,最好配合 Git 钩子自动更新。
- 重名要靠完整 ID。 大项目里
Spider、Config这种通用名很多,Graphify 会提示候选,不会替你乱选,但需要你(或 AI)多一步指定。 - 它是给 AI 用的,不是给人看的图。
graph.html好看归好看,真正有用的是graph.json和命令行查询。
适合谁
| 情况 | 建议 |
|---|---|
| 经常让 AI 接手中大型陌生仓库 | 值得装,建图几乎零成本 |
| 多个 Agent 并行改同一个项目 | 配合 watch 或 Git 钩子,让大家看同一张最新的图 |
| 只写几十个文件的小脚本 | 收益不大,直接让 AI 读文件就行 |
| 资料库以 PDF、图片为主 | 能用,但要花模型费用,先拿一小部分试 |
参考来源
- Graphify GitHub 仓库(含中文 README)
- Graphify 官方文档
- PyPI:graphifyy
代码图谱解决的是「仓库结构怎么查」;若关心跨会话记忆怎么写、怎么用 dreaming 校对,可以看 Anthropic Agent Memory。


