
写 Python 爬虫,很多人的路线都差不多:先用 requests 加 BeautifulSoup 抓几页,页面一多就换 Scrapy,遇到 JavaScript 渲染的页面再接上 Playwright。三套东西各有一套写法,网站一改版,CSS 选择器失效,又得回头一个个修。
Scrapling 想把这几件事收进一个库:发请求、解析页面、写成批量爬虫、给 AI 助手调用,都用同一套 API。它在 GitHub 上有约 8.8 万颗星,10 月 18 日刚发布 0.5 版。
这篇不按功能清单一条条翻译 README,而是从一行代码开始,一步步做到一个能翻页、能导出 CSV 的爬虫。下面的代码我都在自己的 Linux 机器上跑过,用的是专门给人练爬虫的两个测试站 quotes.toscrape.com 和 books.toscrape.com,截图里是真实输出。测试时间 2026 年 10 月 18 日(北京时间),版本 Scrapling 0.5,Python 3.13。
先看基本信息
| 项目 | 情况 |
|---|---|
| 作者 | Karim Shoair(GitHub:D4Vinci),埃及开发者 |
| 开源协议 | BSD-3-Clause,可以商用,保留版权声明即可 |
| Python 版本 | 3.10 及以上 |
| 最新版本 | 0.5,北京时间 2026-10-18 05:43 发布,有不少不兼容改动 |
| 安装 | pip install scrapling,按需加 extras |
| 文档 | scrapling.readthedocs.io,README 有简体中文版 |
它的功能大致分四块:
- 抓取:
Fetcher发普通 HTTP 请求,可以模拟浏览器的 TLS 指纹和请求头,支持 HTTP/3;DynamicFetcher和StealthyFetcher用浏览器渲染 JavaScript 页面。 - 解析:CSS、XPath、文本和正则查找,「找相似元素」,以及这篇重点要演示的自适应元素定位(adaptive)。
- 爬虫框架:写法接近 Scrapy 的
Spider,带并发控制、robots.txt 遵守、自动限速、暂停续爬,可以导出 JSON / JSONL / CSV / XML。 - 给 AI 用:命令行一键把网页存成 Markdown,还有一个 MCP 服务器,可以接到 Claude、Cursor 这类 AI 编程工具里。
装哪个包,取决于你要做什么
这里有个容易踩的坑:只运行 pip install scrapling,装上的只有解析器。这时候 from scrapling.fetchers import Fetcher 会直接报 ModuleNotFoundError,README 里专门用醒目的框提醒过这一点。
| 你要做的事 | 安装命令 |
|---|---|
| 只解析已有的 HTML | pip install scrapling |
| 发请求、写爬虫 | pip install "scrapling[fetchers]" |
| 用浏览器抓 JS 页面 | 上一条之后再运行 scrapling install,下载浏览器 |
命令行 extract 和交互式 shell |
pip install "scrapling[shell]" |
| MCP 服务器(给 AI 助手用) | pip install "scrapling[ai]" |
| 全部装上 | pip install "scrapling[all]" |
只发 HTTP 请求的话不需要装浏览器。我这次装的是 scrapling[fetchers,shell],没有运行 scrapling install,所以下面的例子都没有用到浏览器。
python3 -m venv venv && . venv/bin/activate
pip install "scrapling[fetchers,shell]"
第一步:一个请求,拿到结构化数据
先用 Fetcher.get 请求名言测试站,用 CSS 选择器取出每条名言的作者和标签:
from scrapling.fetchers import Fetcher

page = Fetcher.get("https://quotes.toscrape.com/")
print("状态码:", page.status)

for q in page.css(".quote")[:3]:
    text = q.css(".text::text").get()
    author = q.css(".author::text").get()
    tags = q.css(".tag::text").getall()
    print(f"- {author}: {text[:40]}…  标签: {', '.join(tags)}")

print("本页名言数:", len(page.css(".quote")))
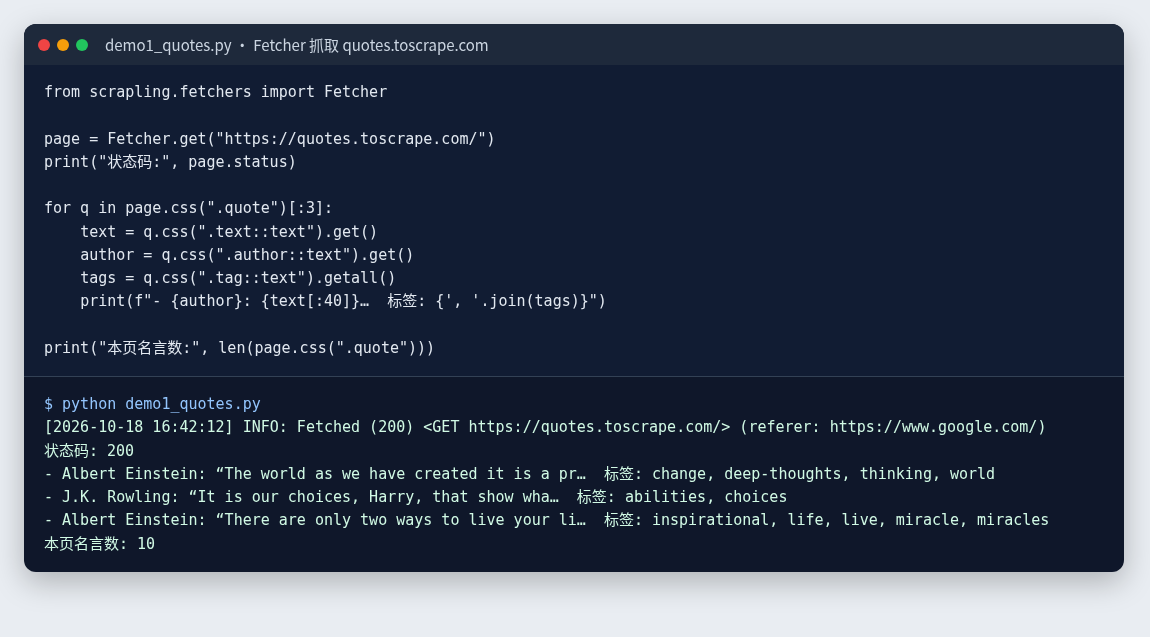
如果你写过 Scrapy 或 parsel,会觉得很眼熟:::text、::attr() 伪元素,.get() 和 .getall() 都是一样的用法。返回的 page 既是响应对象,也能直接用来选择元素,不用再单独把 HTML 交给 BeautifulSoup。
日志里有个细节:Scrapling 默认会带上像真实浏览器一样的请求头,包括 referer: https://www.google.com/。这是它「隐蔽请求」设计的一部分。对测试站没有影响,但你要知道它默认就会这样做。
第二步:网页改版了,选择器还能用吗
这是 Scrapling 最有特色的功能。爬虫最常见的「死法」不是被封,而是对方网站改版:class 换了名字,id 没了,外面多套了一层 div,原来的选择器什么都匹配不到。
Scrapling 的做法是,第一次选中元素时加上 auto_save=True,把这个元素的特征(标签、文本、属性、父级和兄弟节点等)存进本地 SQLite。页面改版后,普通选择器找不到元素,就加上 adaptive=True,它会按相似度在新页面里把元素重新找回来。
我用两段手写的 HTML 模拟一次改版:旧页面里商品是 <article id="p1">;新页面把 id 改成了 data-id,class 也换了,外面还多了一层 wrapper。
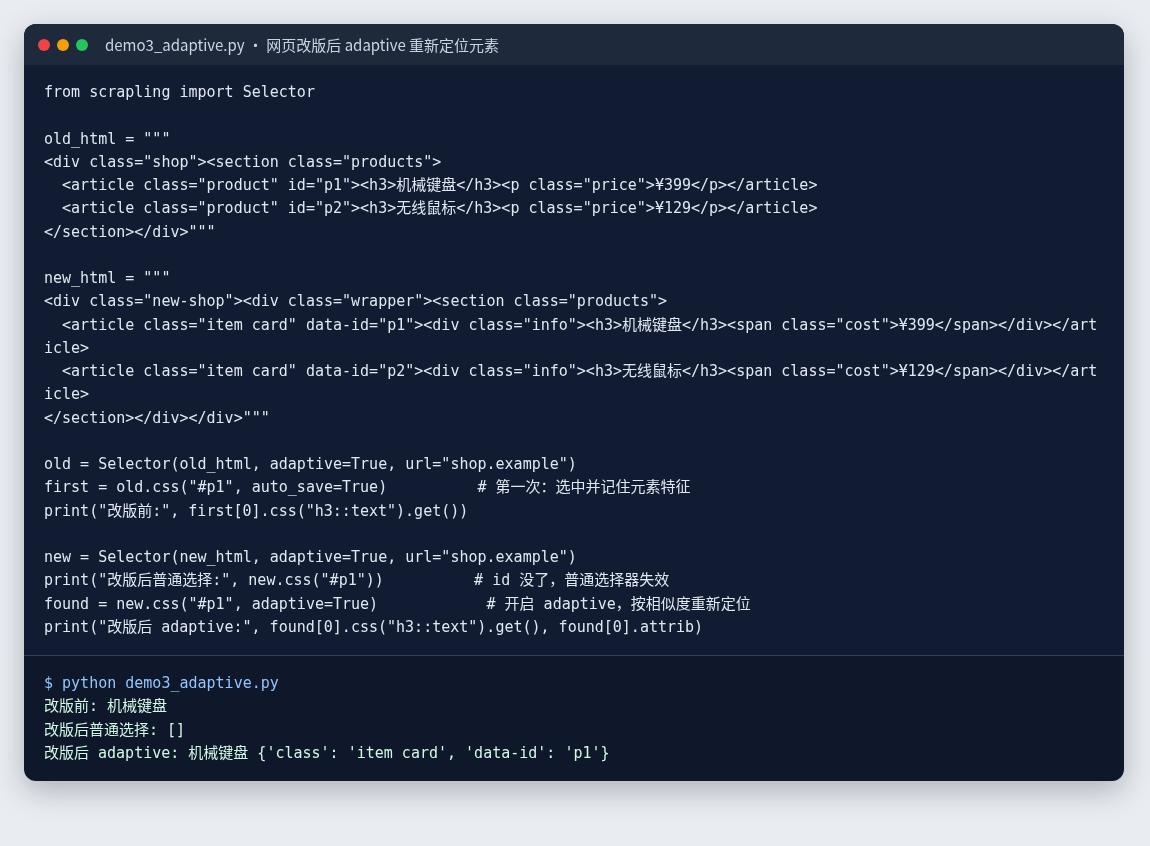
结果很清楚:改版后 css("#p1") 返回空列表,加上 adaptive=True 后仍然定位到了「机械键盘」这个商品,新的属性是 {'class': 'item card', 'data-id': 'p1'}。
需要说明两点:
- 这只是一个很小的例子。真实网站改版的幅度可能大得多,相似度匹配不保证每次都对。它能帮你少修一些选择器,但抓取结果还是要做校验。
- 元素特征是按
url参数(实际是域名)分开保存的,所以新旧页面要用同一个url。
第三步:写成一个会翻页的爬虫
抓几页数据用 Fetcher 就够了。要批量抓取,Scrapling 0.5 自带 Spider 框架,写法和 Scrapy 很像:定义起始地址,在 parse 里 yield 数据和下一页的请求。
下面这个爬虫抓图书测试站的书名、价格和库存。我刻意把「礼貌」设置写进了代码:遵守 robots.txt,只允许两个并发,每次请求间隔 1 秒,只抓前 3 页:
from scrapling.spiders import Spider, Response

class BooksSpider(Spider):
    name = "books"
    start_urls = ["https://books.toscrape.com/catalogue/page-1.html"]
    allowed_domains = {"books.toscrape.com"}
    robots_txt_obey = True      # 遵守 robots.txt
    concurrent_requests = 2     # 并发别开太大
    download_delay = 1.0        # 每次请求间隔 1 秒
    max_pages = 3               # 演示只抓前 3 页

    async def parse(self, response: Response):
        for book in response.css("article.product_pod"):
            yield {
                "title": book.css("h3 a::attr(title)").get(),
                "price": book.css(".price_color::text").get(),
                "stock": book.css(".availability::text").getall()[-1].strip(),
            }
        page_no = int(response.url.rsplit("-", 1)[-1].split(".")[0])
        nxt = response.css("li.next a::attr(href)").get()
        if nxt and page_no < self.max_pages:
            yield response.follow(nxt)

result = BooksSpider().start()
print("抓到图书:", len(result.items))
result.items.to_csv("books.csv")
注意 max_pages 不是 Scrapling 的内置参数,而是我自己加的属性,在 parse 里判断页码。
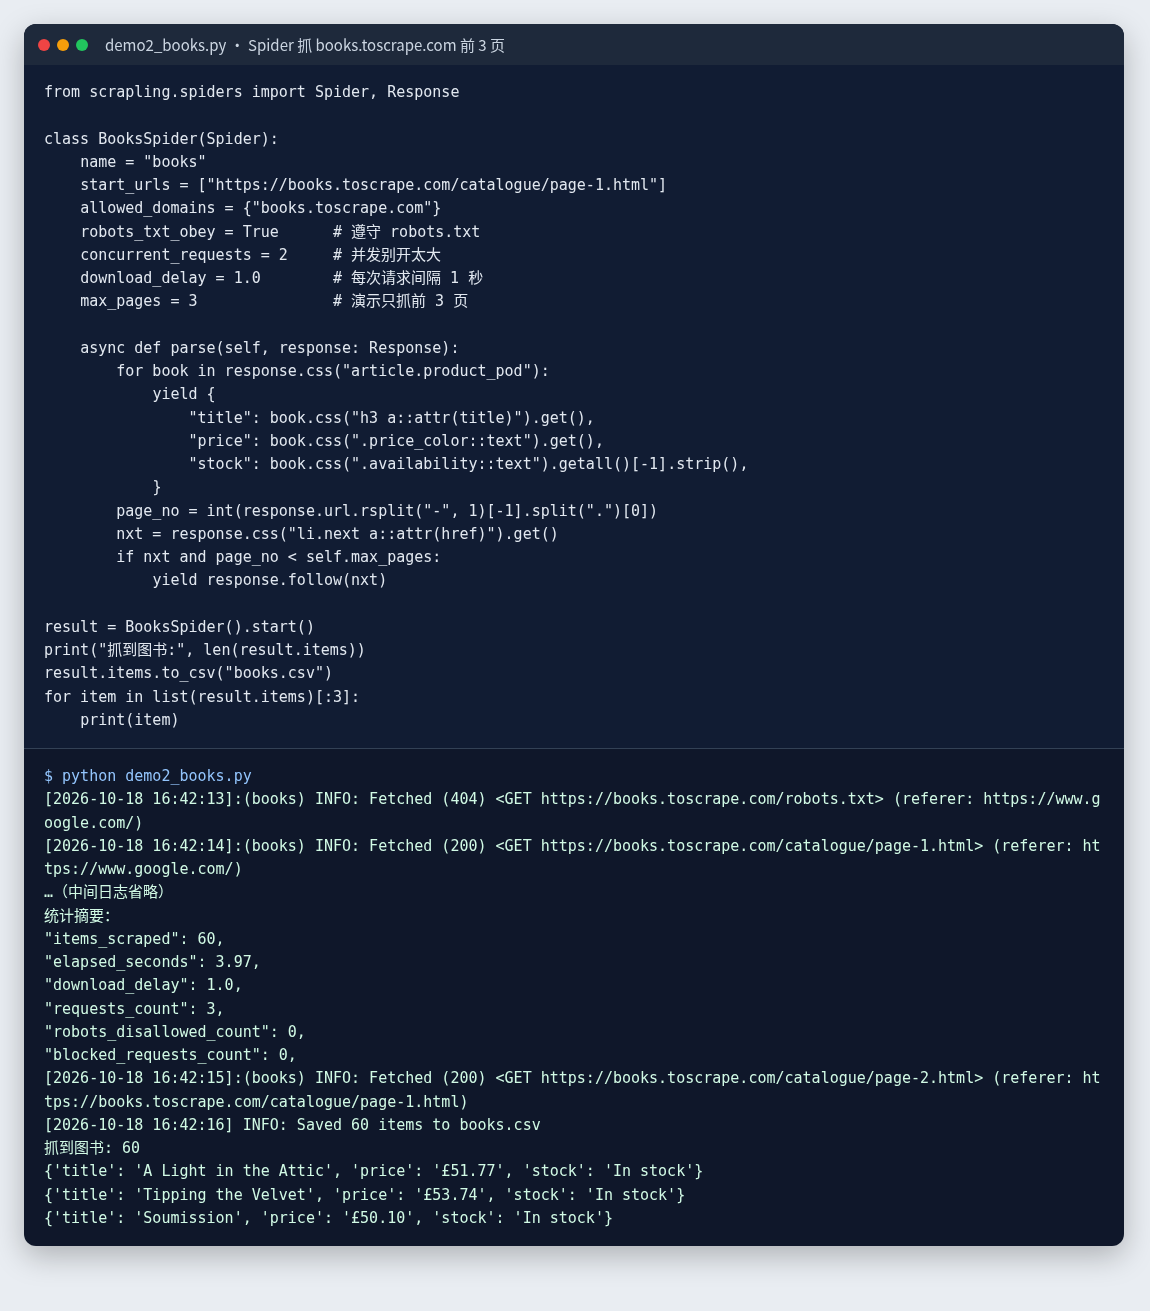
从日志能看到几件事:
- 开启
robots_txt_obey后,爬虫会先请求 robots.txt。这个测试站返回 404(没有 robots.txt),所以全部放行,robots_disallowed_count是 0。 - 3 个请求全部返回 200,抓到 60 本书,统计里的
elapsed_seconds是 3.97 秒,大部分时间花在我设的 1 秒间隔上。 result.items.to_csv()直接导出 CSV,生成的 books.csv 有表头加 60 行数据。
爬虫框架还有几个实用功能我没在这里演示,README 和文档里写得比较清楚:创建爬虫时传入 crawldir 目录(如 BooksSpider(crawldir="./crawl_data")),按 Ctrl+C 停下后,用同一目录再启动就能从断点继续;同一个爬虫里可以混用 HTTP 和浏览器会话;还有 CrawlSpider、SitemapSpider、ContentSpider 等现成模板。
不写代码:一条命令把网页存成 Markdown
装了 shell extras 之后,可以直接在终端提取网页内容,文件扩展名决定输出格式(.md / .txt / .html):
scrapling extract get 'https://quotes.toscrape.com/' quotes.md --css-selector '.quote .text'
我实际运行后,quotes.md 里是本页 10 条名言的正文,每条之间空一行。不加 --css-selector 就保存整页的 Markdown。这个功能适合临时把一篇文档、一个页面喂给 AI 当上下文,比复制粘贴干净。
另外还有 scrapling shell 交互式环境,可以边试选择器边看结果,调试比反复运行脚本方便。
给 AI 助手用:MCP 服务器(本文未实测)
pip install "scrapling[ai]" 之后运行 scrapling mcp,就能把 Scrapling 作为 MCP 服务器接进 Claude Code、Cursor 等支持 MCP 的工具,让 AI 自己去抓网页、提取内容。0.5 版大幅扩展了 MCP 功能,按 release notes 的说法,可以在浏览器里填表、点击、执行 JavaScript、截图、查看页面发出的网络请求。项目还提供了一个 Agent Skill。
这部分我没有实际测试,具体的配置方法请看官方文档的 MCP 章节。不了解 MCP 是什么的话,可以先看看 AI 编程 Agent 生态全景,里面整理了这类工具的分类。
如果你只是想让 AI 联网查资料,未必要自己搭爬虫,用现成的搜索接口往往更省事,比如 DeepSeek 搜索 API 的 Search / Fetch 接口。
先把规矩讲在前面
Scrapling 的 README 首页有大段介绍「隐蔽抓取」和处理 Cloudflare 验证的能力,赞助商列表里也大多是代理和反爬服务商。这些能力本身是中性的,但我想提醒几句:
- 先看 robots.txt 和网站服务条款。 对方明确禁止抓取的内容就不要抓。Spider 里把
robots_txt_obey = True打开,成本几乎为零。 - 控制频率。 设置
download_delay、降低并发,或者打开 AutoThrottle 自动限速。别人的服务器不是你的压测环境。 - 隐蔽功能不是「破门工具」。 浏览器指纹伪装、验证码处理,应该用在你有权访问的场景,比如测试自己的网站、抓取明确允许采集的公开数据。用它绕过别人专门设置的访问限制,可能违反服务条款,甚至触犯法律。
- 注意个人信息和版权。 抓到的数据里有用户隐私、付费内容的,不要随意存储、转发或商用。
Scrapling 的 README 自己也写了免责声明:仅用于教育和研究,使用者要遵守当地和国际的数据抓取与隐私法律,尊重网站的服务条款和 robots.txt。
适合谁,不适合谁
适合:
- 写过 requests + BeautifulSoup 的个人开发者,想要一个上手快、又能扩展成批量爬虫的库。
- 要长期维护一批抓取脚本,被网站改版折腾烦了,可以试试 adaptive。
- 需要把网页内容整理成 Markdown,给 AI 或 RAG 知识库用。
先等等再说:
- 已经有稳定运行的 Scrapy 项目,没必要为了换库而迁移。Scrapy 的中间件和插件生态更成熟。
- 0.5 版刚发布,有大量不兼容改动。如果你在用 0.4 或更早的版本,先看官方迁移指南,别直接升级生产环境。网上很多教程是按旧版写的,照着抄可能会报错。
- 目标网站提供官方 API 的,优先用 API。比如想要古诗词数据,直接调用 Chinese Poetry API 这类现成接口,比自己写爬虫稳定得多。
- 只是偶尔要从几个登录后的网页里整理表格,不想写代码的话,可以试试浏览器扩展 轻舟(qz),用一句话让 AI 在自己的 Chrome 里查完并附上来源。
资料来源
- GitHub 仓库:https://github.com/D4Vinci/Scrapling
- 官方文档:https://scrapling.readthedocs.io/
- PyPI:https://pypi.org/project/scrapling/
本文中的代码和输出均来自 2026 年 10 月 18 日的实际运行。浏览器类抓取器(DynamicFetcher / StealthyFetcher)和 MCP 服务器没有测试,相关描述来自官方 README 和 0.5 版 release notes。


