
用 AI 写代码久了,大概都遇到过这种情况:Claude Code 的额度用完了,换到 Codex 接着干,结果得把项目架构、刚才试过哪些方案、哪条路走不通,从头再讲一遍;或者白天在公司电脑上做了一半,晚上回家换台电脑,AI 又什么都不记得了。
ai-memory 就是来解决这个的。它是巴西开发者 Fabio Akita(AkitaOnRails)做的开源项目,给 AI 编程助手加一层跨工具、跨电脑、可共享的长期记忆:Claude Code 做到一半退出,在同一个目录打开 Codex,接手的 Agent 会收到一份交接说明,写着做到哪了、什么失败了、还有哪些问题没解决。项目 MIT 协议,GitHub 上 1.1 万多星,10 月 20 日登上 GitHub 趋势榜,当天新增 600 多星。资料查阅于 2026 年 10 月 20 日,来自 GitHub 仓库 README 和官方文档。
Claude Code 自己不是有记忆吗?
有,但各家的记忆都有同样的局限:存在一台电脑上、只属于一个 Agent,换工具或者交给同事就看不到了。ai-memory 的区别在于:
- 跨 Agent:官方列出的一方集成超过 20 个,包括 Claude Code、Codex、Cursor、Gemini CLI、OpenCode、GitHub Copilot CLI、Kimi Code、Kiro、Grok Build CLI 等,所有 Agent 往同一份记忆里写、从同一份记忆里读。
- 跨电脑:记忆存在你自己跑的一个服务里,可以是本机,也可以是家里的服务器,台式机和笔记本连同一个服务,看到的就是同一份项目记忆。
- 跨项目:会记住你的个人习惯(用什么包管理器、测试怎么组织之类),新项目一打开就带上,不用每个仓库再说一遍。
- 能给团队用:大家指向同一台服务器,知识按项目共享,个人的交接单只自己能看;多用户认证、按人归属和审计日志都是内置的,不是付费功能。
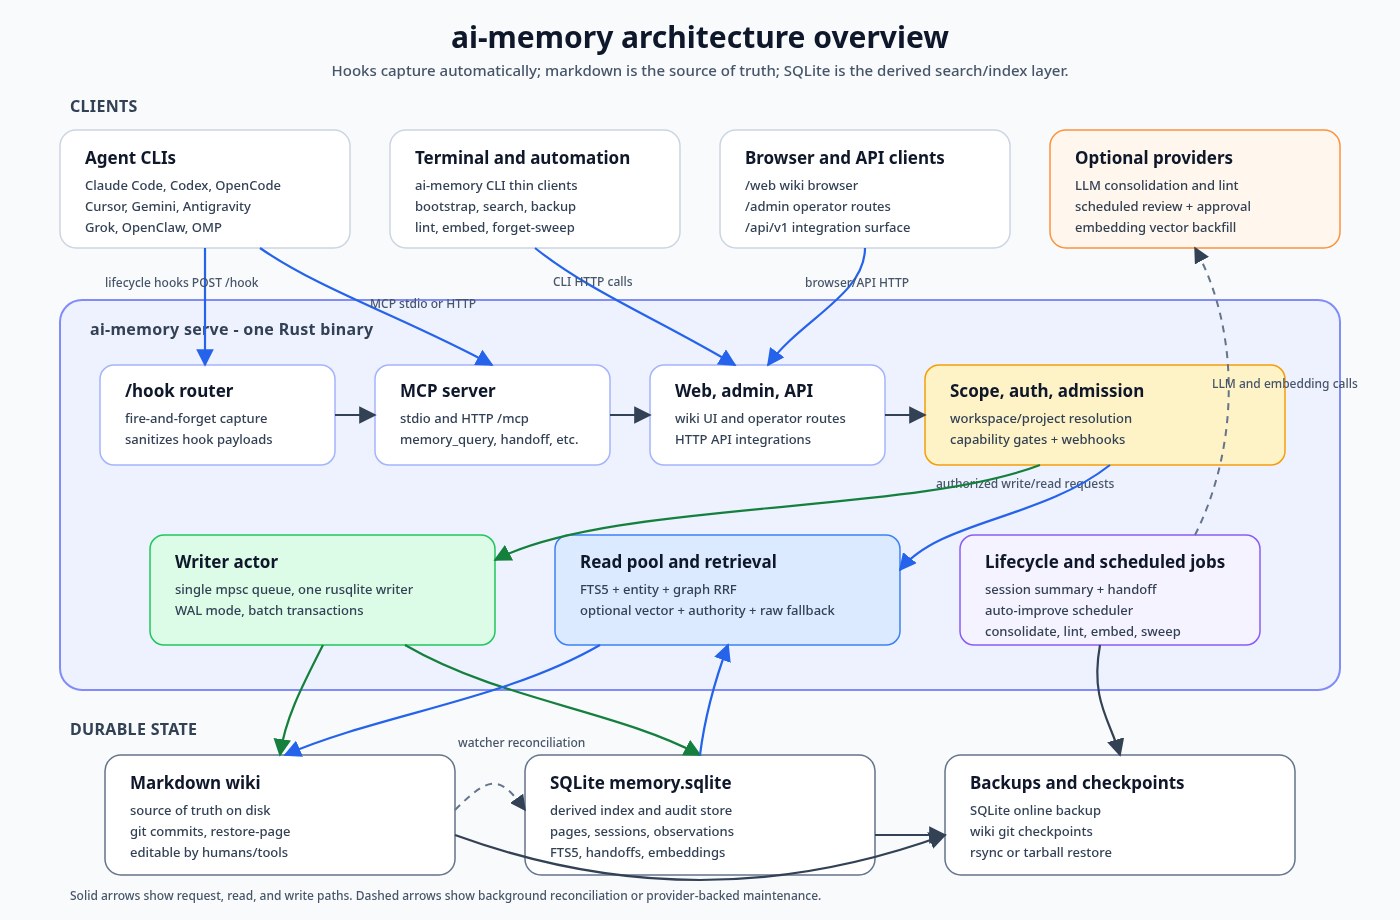
- 记忆是普通 Markdown 文件:真正的数据是一个用 git 管理的 wiki,可以 grep、用 Obsidian 打开、手动改;数据库只是从这些文件派生出来的索引,随时能重建。
它是怎么记住的?
流程是四步:捕获 → 整理 → 回忆 → 交接。
- 捕获:通过各个 Agent 的生命周期钩子(hooks),自动记录你的提问、工具调用、会话开始和结束。你不用专门说“记住这个”。存进去之前会经过一层脱敏处理。
- 整理:会话结束时,把这些记录整理成可读的 wiki 页面。
- 回忆:下个会话开始时,任何 Agent、任何电脑都会拿到一份有长度上限的简报,并且可以搜索全部记忆(全文检索、实体、链接,可选向量检索)。
- 交接:跨 Agent 交接是一个明确的协议,每份交接单有归属人,只会被领取一次。
最值得一提的是,默认路径完全不调用大模型:捕获、搜索、交接都不需要 API Key。配了模型以后,会话总结写得更好,还能开语义搜索。旧记忆会按规则慢慢“降温”,经常被用到的衰减得更慢;原始版本始终留在 git 里,可以找回。
怎么装?
Linux / macOS,两条命令,不需要 root:
curl -fsSL https://github.com/akitaonrails/ai-memory/releases/latest/download/install.sh | sh
ai-memory setup
第一条下载适合你系统和 CPU 的版本,校验 SHA-256 不通过就拒绝安装,装到 ~/.local/bin/ai-memory。第二条 setup 会创建数据目录(Linux 用户服务默认在 ~/.local/share/ai-memory)、生成一个只有你能读的访问令牌、注册开机自启的用户服务(Linux 用 systemd --user,macOS 用 LaunchAgent),然后找出本机装了哪些 Agent,给它们接上 MCP、钩子和 Agent Skills。它会先列出计划问你,回答 y 或者输入要接的编号;加 --plan 只看计划不改动。装完重启 Agent,问一句“What do you remember about this project?” 就能验证。
Windows(PowerShell,不需要管理员):
irm https://github.com/akitaonrails/ai-memory/releases/latest/download/install.ps1 | iex
ai-memory setup
注意原生 Windows 在官方支持表里还是实验性的,更稳的是走 WSL2。
只用 Claude Code / Codex 的,也可以装成插件(二进制仍要按上面装好):
claude plugin marketplace add akitaonrails/ai-memory && claude plugin install ai-memory@ai-memory
codex plugin marketplace add akitaonrails/ai-memory && codex plugin add ai-memory@ai-memory
另外还有 Docker 镜像(amd64 / arm64 都有)、Arch 的 AUR 包、Fedora 的 RPM 包和 macOS 菜单栏 App(需要自己编译),不想装了运行 ai-memory uninstall --apply 就能把 setup 接上的东西全部撤掉。
日常怎么用?
装好之后基本不用管它,直接跟 Agent 说话就行:
| 你想做什么 | 跟 Agent 说 |
|---|---|
| 接着上次的活干 | “Where did we leave off?” |
| 查以前讨论过没有 | “Have we discussed X?” / “search memory for Y” |
| 离开几天后快速了解进展 | “Catch me up” |
| 记一条长期规则 | “Remember that we always use pnpm here” |
| 收工前存好上下文 | “Wrap up — save context for next time” |
想在不同 Agent 之间无缝切换,作者推荐用 ai-memory run 来启动 Agent:
ai-memory run claude
ai-memory run codex      # 接手同一个工作流,还能看到刚才 Claude 会话的本地历史
ai-memory continue       # 恢复最近的一个工作流
ai-memory resume         # 从当前目录的所有工作流里挑一个
run 第一次启动某个 Agent 时会自动补装它缺的钩子和 MCP;切换时,接手的 Agent 除了共享记忆,还会拿到上一个 Agent 本地会话历史的一份临时副本,用来补细节。按官方说法,这份会话正文不会发给服务端,服务端只收到是哪个 Agent、哪个会话。
已经做了好几个月的老项目,可以先跑一次 ai-memory bootstrap 把历史导进来;启动服务时加 --enable-web,还能在浏览器里只读地翻看 wiki。
记下来的东西安全吗?
它会自动记录你的提问和工具调用,所以这个问题要认真看。官方的说法是:
- 默认完全本地,没有遥测:不上报统计、不上传崩溃日志,数据都在你自己的数据目录里。默认的向量模型 all-MiniLM-L6-v2 也在本机跑。
- 只有三种情况会把数据发出去,而且都要你主动开:把向量模型换成 OpenAI、Voyage、Google 等云端服务(会把每个记忆页面的全文发过去,切换后还会把已有的全部记忆补发一遍);开启记录 AI 回复的功能(需要服务端和客户端两边都开);开启用大模型给搜索结果重排序。
- 脱敏只能去掉明显的密钥,官方自己说是“尽力而为,不是保证”;数据没有静态加密,靠系统文件权限保护。
- 服务默认只监听本机
127.0.0.1(端口 49374)。原生安装会自动生成访问令牌;但 Docker 快速启动那种方式默认没有认证,同一台机器上的其他程序和网页都能访问它,要用ai-memory auth enable打开。想放到家里服务器上给几台电脑共用,还要按文档加令牌、配 HTTPS 反向代理。
我们的建议:项目里有密钥、客户资料的,先在仓库里用 [capture] 规则排除敏感路径(也可以改成白名单模式),向量模型保持默认的本地模式。
国内用户要注意什么?
以下是我们根据文档和代码做的判断,没有实测:
- 默认的本地向量模型第一次启动时会从 Hugging Face 下载,国内网络可能下不下来。下不下来全文检索照样能用;文档也给了离线安装的办法,手动下好三个模型文件放进
<数据目录>/models/all-MiniLM-L6-v2/即可。 - 中文检索效果可能打折扣。 它的全文检索用 SQLite FTS5 的 unicode61 分词,对不带空格的中文切词很粗;默认的 all-MiniLM-L6-v2 主要面向英文。中文写的笔记能存能读,但用中文提问时召回可能不如英文准。在意的话,可以接一个支持中文的向量服务,或者干脆用英文写规则和关键词。
- 想让它用大模型写总结,可以接任何 OpenAI 兼容接口。官方示例是通过 OpenRouter 调
deepseek/deepseek-v4-flash,并建议设AI_MEMORY_LLM_COMPAT_STRICT=true,因为 DeepSeek 等模型有时会把 JSON 包在 Markdown 代码块里导致丢字段。本地的 Ollama、LM Studio、vLLM 也支持。
有什么缺点?
- 迭代非常快:10 月 7 日到 17 日发了十来个版本,10 月 14 日刚升到 3.0 大版本,从 2.x 升级要先看官方的迁移文档。
- 概念和文档都很多:工作流、交接、作用域、衰减、多用户……只想“换个 Agent 不用重复解释”的个人用户,用默认的
setup就够了,别一上来就研究团队部署。 - 原生 Windows 还是实验性的;部分 Agent(如 Claude Desktop、VS Code Copilot、Zed)只支持 MCP,没有钩子,就不能自动捕获。
- 自动记录意味着它会存下大量会话内容,记得定期看看 wiki 里都记了什么。
和其他工具怎么搭?
ai-memory 管的是“记住什么”,和下面几类工具不冲突:Context Mode 管的是“一次会话里少往上下文塞东西”;Magpie 帮你在菜单栏一键给 Claude Code、Codex 换模型;Orca 让多个 Agent 各开一个 worktree 并行干活。想先把这些工具的关系理清楚,可以看 AI 编程 Agent 生态全景。
适合谁
- 适合:同时用两三个 AI 编程工具、经常因为额度或效果来回切换的人;台式机、笔记本两头写代码的人;想给小团队搭一个共享“项目知识库”的人。
- 不太需要:只用一个 Agent、只在一台电脑上写代码的人,Agent 自带的记忆基本够用;对“自动记录所有提问”有顾虑又不想花时间配置排除规则的人。
项目信息
- 最新版本:v3.1.1(2026 年 10 月 17 日)
- 语言 / 形态:Rust 写的单个二进制,内置 MCP / HTTP 服务,数据是 git 管理的 Markdown + SQLite 索引
- 系统:Linux、macOS 正式支持,Windows 推荐 WSL2(原生为实验性)
- 授权:MIT,免费开源,默认不需要任何 API Key
- 仓库与官网:akitaonrails/ai-memory|aimemory.sh|安装文档|数据处理说明


