
想把一本电子书变成有声书,常见的办法有三种:等平台出正版有声书,用手机自带的朗读功能凑合听,或者把书稿贴进在线配音网站按字数付费。第一种可能等不到,第二种机械音听不了几章,第三种一本二三十万字的书费用不低,书稿还要上传到别人服务器。
Folivox 走的是第四条路:在自己电脑上,用开源语音模型把整本书读出来,生成带章节的 .m4b 有声书或者按章节分开的 MP3。默认的朗读引擎是阿里通义实验室开源的 CosyVoice 3,能用几秒钟的样本克隆声音,不用账号、不用订阅、不按字收费,书稿不离开你的电脑。资料查阅于 2026 年 10 月 18 日,来源是 GitHub 仓库 README 和安装文档。
它能做什么,先用一张表说清
| 项目 | 内容 |
|---|---|
| 输入格式 | FB2、EPUB、DOCX、PDF(只认文字层,不做 OCR)、TXT |
| 输出 | 一个带章节标记、封面和元数据的 .m4b,或每章一个 .mp3;响度统一到 −18 LUFS |
| 本地引擎 | CosyVoice 3(默认,免费);Fish Audio Drama 3(80 多种语言、一场戏多个声音,需要内存足够的 Mac) |
| 在线引擎(可选) | ElevenLabs、OpenAI、Gemini、Cartesia、Fish Audio,用你自己的 API Key |
| 操作方式 | 浏览器里的网页工作台(folivox ui,界面有中文)或命令行 |
| 系统 | macOS、Windows、Linux;Apple Silicon、NVIDIA 显卡或纯 CPU |
| 协议 | Apache-2.0,CosyVoice 3 权重也是 Apache-2.0 |
| 状态 | 早期开发,GitHub 仓库 10 月 11 日创建,查阅时 94 星,一个人维护 |
和“让 AI 读一段文字”有什么不同
单独跑一个 TTS 模型读几句话不难,难的是读完一整本书。Folivox 的价值主要在模型之外的那些活:
- 把文字整理成适合朗读的样子。数字、日期、时间、金额、单位、罗马数字、缩写都会展开成读法。中文有专门的规则,比如该读“两”的地方不读“二”。俄、英、德、法、西、意、中、日、韩 9 种语言有完整规则。
- 保留书的结构。章节、嵌套小节、诗歌、题记都会保留;PDF 的页眉页脚和页码会被去掉,断词连字符会被还原。
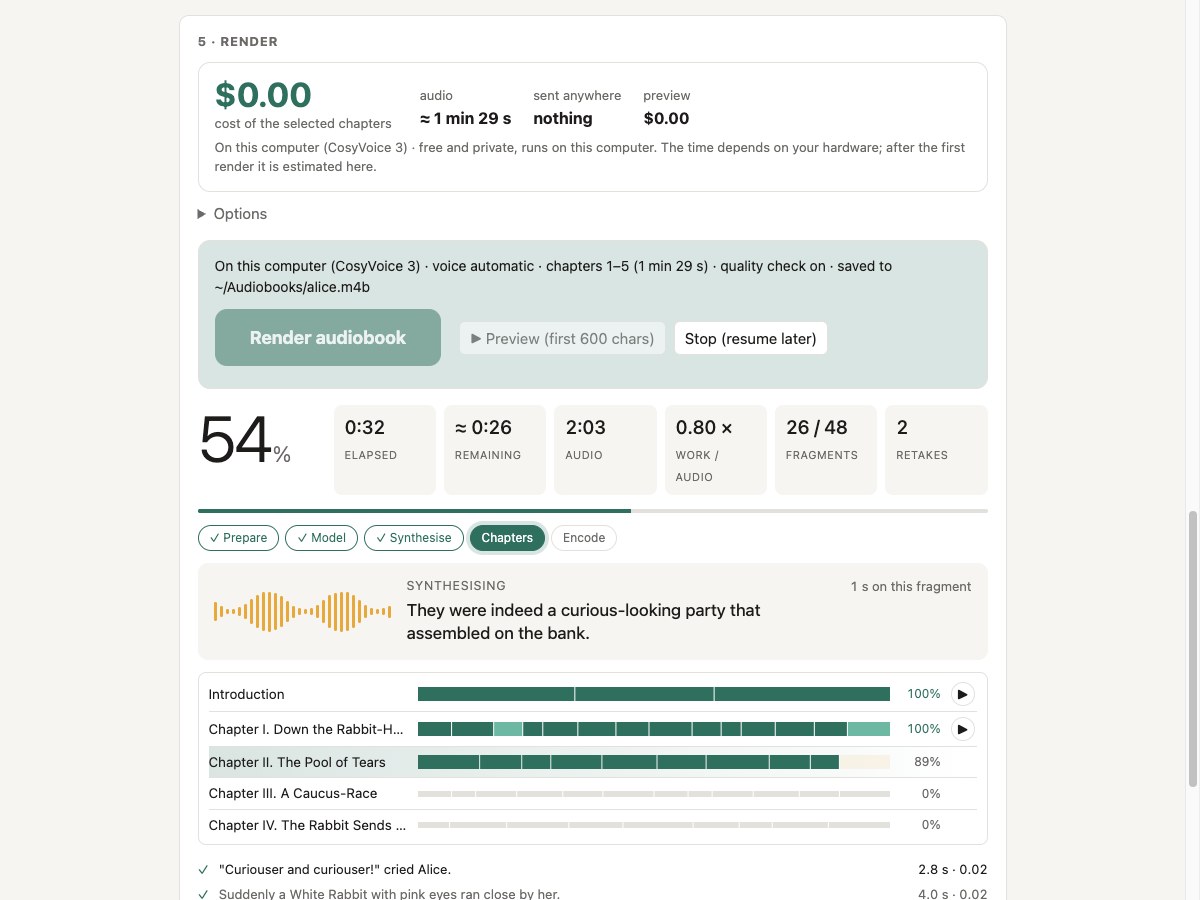
- 逐段质检。每一段读完都会用 Whisper 听写一遍,和原文对不上就重读,默认读 3 遍取最好的一遍。
- 适合十几个小时的长书。每完成一段就记一笔,中途停掉、程序崩溃、断电,再运行同一条命令就从没读完的地方继续。改了文字,只重读改过的段落。
- 一本书多个声音。旁白和角色可以各用一个声音,本地大模型能自动标出谁在说话,再在工作台的标注编辑器里检查修改。
安装:一条命令,但要留出 8 GB 空间
Windows 打开 PowerShell,粘贴下面这行回车:
irm https://raw.githubusercontent.com/vatavale/folivox/main/scripts/install.ps1 | iex
macOS 和 Linux 在终端里运行:
curl -fsSL https://raw.githubusercontent.com/vatavale/folivox/main/scripts/install.sh | bash
安装脚本不需要管理员权限,会依次装好 uv、检查并安装 ffmpeg、按你的硬件挑合适的 PyTorch 版本(NVIDIA 显卡、Apple Silicon 或体积更小的 CPU 版;RTX 50 系显卡会装 PyTorch 2.7 和 CUDA 12.8),然后下载模型:朗读模型约 6 GB,质检用的 Whisper 约 1.6 GB,断了可以续传。
装好后打开一个新的终端窗口:
folivox ui
浏览器会打开工作台:拖进一本书,选一个声音,点 Render audiobook。想先听听效果,用预览功能只读前几百个字。停止工作台在终端按 Ctrl + C。
三点提醒:
- Windows 用户要有心理准备。安装文档写得很坦白:脚本只在 macOS 上真正跑过,Windows 脚本和 CUDA 版 PyTorch 的选择还没在真实的 Windows 和 NVIDIA 机器上测试过。装不上的话,按文档里的排错说明处理,或者到 Issues 反馈。
- 新装的 Windows 11 可能被“智能应用控制”拦住,报错
os error 4551。安装脚本会自动改用 python.org 签名过的 Python 3.12,不用关掉智能应用控制。 - 国内下载模型可能很慢。Folivox 用 huggingface_hub 从 Hugging Face 下载模型,理论上可以先设置环境变量
HF_ENDPOINT=https://hf-mirror.com走镜像,但我们没有实测它是否对所有模型都生效。
想在 NAS 或家里的服务器上跑,官方也有 Docker 部署文档,支持 CPU 和 NVIDIA 显卡。
三种用法:全免费、几乎免费、花钱买最好
1. 全本地,完全免费。 用 CosyVoice 3,声音可以来自自带的声音库,也可以用你自己的录音:在工作台里直接用麦克风录,或者上传一段 6 到 15 秒的样本。手头只有视频或长录音也行,拖进去它会找出单人说话、没有背景音乐的干净片段让你挑。
2. 花几分钱生成一个好声音,再免费读全书。 这是作者最推荐的做法:用 Gemini 生成几段十秒左右的旁白样本(描述你想要的声音,或者点 Suggest from my book 让它根据书的内容写描述),Whisper 帮你排出最好的一段存进声音库,然后用本地 CosyVoice 克隆这个声音读完整本书。README 给出的价格是 Gemini 付费版每 10 秒音频约 0.0023 美元,Gemini 也有免费额度(各家免费额度可以看我们的 2026 免费用 AI 完全指南)。
3. 全书交给在线引擎。 作者的看法是,商业引擎读全书的效果仍然比本地克隆好,推荐 Gemini 3.8 Flash TTS,按 README 写的 2026 年 10 月标价,每小时音频约 0.8 美元,十小时的书约 8 美元。开始前会先给出费用估算,等你确认,还可以设消费上限:
folivox render book.epub --tts gemini --tts-mode design --tts-describe "calm, warm audiobook narrator" --max-cost 10
用在线引擎时书的文字会发给对应的服务商,工作台会明确标出来并先问你。
常用命令
folivox inspect book.epub                  # 查看章节结构、字数、预计时长
folivox book.epub -v me.wav -o book.m4b    # 用自己的声音读整本书
folivox book.epub -c 1-2 --preview 600     # 只试读第 1-2 章,每章前 600 字
folivox book.pdf --mp3 -o out/             # 每章输出一个 mp3
folivox doctor                             # 检查 ffmpeg、硬件、模型和磁盘空间
folivox bench                              # 测一下本机每秒能合成多少字
要多好的电脑,读一本书要多久
官方要求 Python 3.10 到 3.12(安装脚本会处理)、ffmpeg,以及约 7.6 GB 的模型空间。Apple Silicon 的 Mac、带 NVIDIA 显卡的 Windows / Linux 都能加速;纯 CPU 也能跑,只是慢。AMD 和 Intel 显卡只有一条实验性的路线。
读一本书要多久,作者故意不给数字,因为差别太大。工作台会在开始前显示有声书的总时长,根据你之前的运行记录估算渲染时间,运行中显示剩余时间。建议先用 folivox bench 测一下,再用预览试读一小段,确定声音满意了再开整本。
用之前要知道的几件事
- 中文不是它的“主场”。从项目关键词和 README 的例子看,作者最早是为俄语书做的,中文有专门的文字规则,但我们没有找到中文长书的实际试听样例。建议先用一章试读,重点听多音字、人名和数字读得对不对。读错的名字和生词,可以在书旁边放一个纯文本发音词典(格式是
原词 = 读法),工作台里也能改。 - PDF 只认文字层。扫描版 PDF 要先做 OCR 转成文字。
- 只克隆你自己的声音,或者明确授权给你的声音。Folivox 不自带名人或第三方声音,也没有模仿真人的功能;自带的声音来自 LibriVox 志愿者捐给公有领域的录音。
- 生成的有声书怎么用,取决于原书的版权。自己的书、公版书没问题;买来的电子书转成音频自己听,和拿去公开发布是两回事,后者需要版权方授权。
和其他本地语音工具怎么选
- 只想把整本书变成有声书:Folivox 最对口,断点续读、逐段质检、章节输出都是为这件事做的。
- 还想做视频配音、转录、听写:VoiceStudio 功能更全,有图形安装包,Windows 上上手更容易。
- 自己写代码、想要更强的中文方言和音色设计:可以直接用 VoxCPM2 这类模型,但书的分章、文字整理、质检都得自己做。
优点
- 本地引擎免费无限制,书稿不上传,适合在意隐私或想听冷门书的人。
- 为长书设计:断点续读、只重读改过的段落、成品完成前不覆盖旧文件。
- Whisper 逐段质检,自动重读读错的段落。
- 本地和在线引擎同一套流程,在线引擎先估价再扣钱,可设上限。
- 输出带章节、封面、元数据的
.m4b,常见的有声书播放器都能识别章节。
不足
- 早期开发,一个人维护,Windows 安装脚本还没在真机上测过。
- 第一次要下载近 8 GB 模型,国内网络可能要折腾。
- 需要用到终端,对完全不碰命令行的人有门槛。
- 中文效果缺少公开的长书样例,要自己试。
- Fish Audio Drama 3 本地版只支持内存足够的 Mac。


