
想要一个“声音低沉、语速偏慢的中年男声”,不用找配音演员,也不用准备参考音频,写一句描述就行。VoxCPM2 把音色设计、声音克隆和 30 种语言合成放进了一个 20 亿参数的开源模型里。
本文介绍 VoxCPM2 是什么、能做什么、需要多大显存,怎样安装和使用,以及它和 CosyVoice、F5-TTS、GPT-SoVITS、Fish Speech 的区别。最后单独讲一下声音克隆的法律和伦理边界。资料于 2026 年 10 月 11 日查阅 GitHub 仓库、官方文档和各对比项目的仓库。
VoxCPM2 是什么
VoxCPM 是面壁智能(OpenBMB)联合清华大学人机语音交互实验室开源的语音合成(TTS)系列模型,代码和权重都采用 Apache-2.0 协议,可以免费商用。仓库目前约 3.86 万星。
VoxCPM2 是 2026 年 4 月发布的最新版本:基于 MiniCPM-4 基座,总参数 20 亿,在超过 200 万小时的多语种音频上训练,支持 30 种语言和 9 种中文方言,原生输出 48kHz 音频。
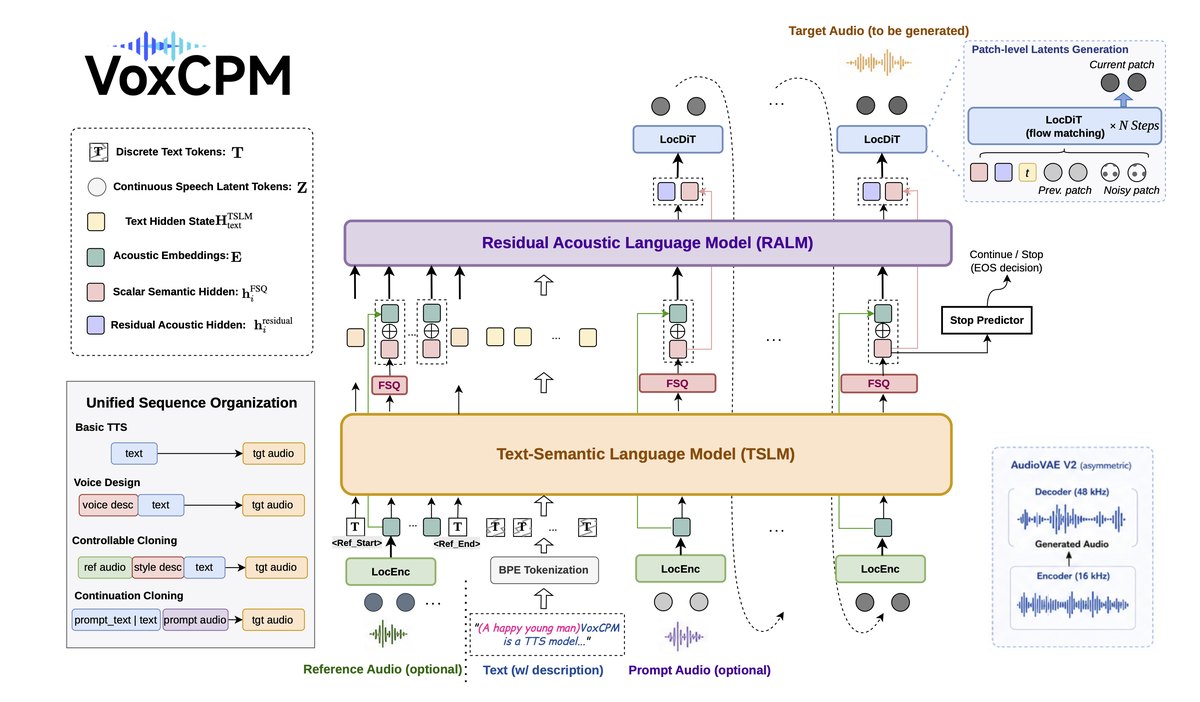
它的技术路线和多数 TTS 不同:不把声音切成离散的音频 token,而是用扩散自回归架构直接生成连续的语音表征,官方称这样合成的声音更自然、表现力更强。
它解决什么痛点
- 找不到合适的声音:做视频、有声书或游戏角色,常常需要一个特定气质的声音,商用音色库可选范围有限。
- 克隆声音要准备文本:不少克隆方案需要参考音频的逐字稿,VoxCPM2 只给音频也能克隆。
- 多语种要换多个模型:中文一个、英文一个、方言再找一个,维护成本高。
- 开源模型商用受限:一些热门开源 TTS 的权重只允许非商业使用,VoxCPM2 是 Apache-2.0。
- 采样率不够:很多模型输出 16kHz 或 24kHz,用在视频和播客里听感偏闷。
主要功能
- 30 种语言合成:直接输入文本,不需要加语言标签。支持中文、英语、日语、韩语、法语、德语、西班牙语、泰语、越南语等,以及四川话、粤语、吴语、东北话、河南话、陕西话、山东话、天津话、闽南话。
- 音色设计:在文本前用括号写一段描述,比如性别、年龄、音色、情绪、语速,模型会凭空生成一个新音色,不需要任何参考音频。
- 可控声音克隆:给一段参考音频就能克隆音色,还能叠加风格指令调整情绪、语速和表现力。
- 极致克隆:同时给参考音频和它的逐字稿,模型接着这段音频续写,还原度更高。
- 48kHz 输出:参考音频只需 16kHz,模型内置超分,直接输出 48kHz。
- 流式合成:官方数据在 RTX 4090 上实时率(RTF)约 0.3,用 Nano-vLLM 加速后约 0.13,也就是生成 10 秒语音只需 1 到 3 秒。
- 微调:支持全参数微调和 LoRA 微调,官方说 5 到 10 分钟的音频就能适配特定说话人或领域。
需要多大显存
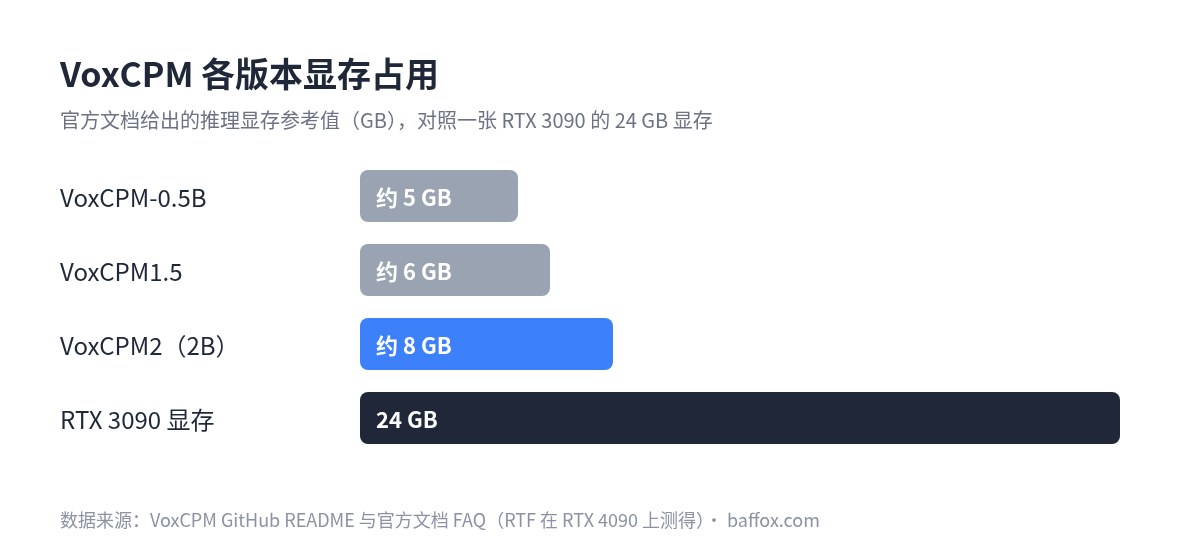
官方 README 和文档 FAQ 给出的推理显存参考值如下,RTF 都是在单张 RTX 4090、开启 torch.compile、推理步数 10 的条件下测得:
| 模型 | 参数量 | 采样率 | 显存 | RTF(标准) | RTF(Nano-vLLM) |
|---|---|---|---|---|---|
| VoxCPM2 | 2B | 48kHz | 约 8 GB | 约 0.30 | 约 0.13 |
| VoxCPM1.5 | 0.6B | 44.1kHz | 约 6 GB | 约 0.15 | 约 0.08 |
| VoxCPM-0.5B | 0.5B | 16kHz | 约 5 GB | 约 0.17 | 约 0.10 |
按官方的约 8 GB 来看,24 GB 显存的 RTX 3090 跑 VoxCPM2 推理绰绰有余,还能留出空间做 LoRA 微调或同时跑其他程序。官方没有公布 RTX 3090 的实测速度,3090 的算力低于 4090,实际速度会比上表慢一些。12 GB 显存的显卡从数字上看也能装下,但我们没有实测。
没有 NVIDIA 显卡也能跑:官方支持 CPU 和 Apple Silicon 的 MPS,只是速度慢很多。社区项目 llama.cpp-omni 提供了 GGUF 量化版本,官方 README 给出的数据是在 Apple M4 Pro 上用 Q8_0 量化时 RTF 约 1.76,也就是比实时慢。
安装
官方要求 Python 3.10 到 3.12、PyTorch 2.5.0 以上、CUDA 12.0 以上。建议先建一个独立的虚拟环境,然后一条命令安装:
pip install voxcpm模型权重第一次运行时会从 Hugging Face 自动下载。国内网络可以先从 ModelScope(魔搭)下载到本地:
pip install modelscopefrom modelscope import snapshot_download
snapshot_download("OpenBMB/VoxCPM2", local_dir="./pretrained_models/VoxCPM2")几个常见坑(来自官方 FAQ):
- 用参考音频克隆时报 torchcodec 错误:新版 torchaudio 需要系统装好 FFmpeg(4 到 7 版),Linux 上用 apt 安装,macOS 用 Homebrew。
- Windows 上 Triton 报错:安装社区的 triton-windows,并让 Triton 版本和 PyTorch 对应;实在不行加载模型时设置 optimize=False,关闭 torch.compile,速度变慢但功能正常。
- 多线程报错:默认的 torch.compile 会用到 CUDA Graphs,和多线程不兼容;要并发服务请用 Nano-vLLM-VoxCPM。
- Python 3.14 装不上:依赖不兼容,换回 3.10 到 3.12。
用法
网页版 Demo
克隆仓库后运行自带的网页界面,浏览器打开 http://localhost:8808 即可:
git clone https://github.com/OpenBMB/VoxCPM.git && cd VoxCPM
pip install -e .
python app.py --port 8808
不想本地安装,可以先在线体验:Hugging Face 上有官方 Space,面壁智能还提供了适合国内访问的体验网站 voxcpm.modelbest.cn。
Python 调用:普通合成和音色设计
from voxcpm import VoxCPM
import soundfile as sf

model = VoxCPM.from_pretrained("./pretrained_models/VoxCPM2", load_denoiser=False)

# 普通合成
wav = model.generate(text="VoxCPM2 是目前推荐使用的多语言语音合成版本。", cfg_value=2.0, inference_timesteps=10)
sf.write("demo.wav", wav, model.tts_model.sample_rate)

# 音色设计:括号里写音色描述
wav = model.generate(text="(年轻女性,声音温柔甜美)你好,欢迎使用VoxCPM2!", cfg_value=2.0, inference_timesteps=10)
sf.write("voice_design.wav", wav, model.tts_model.sample_rate)
声音克隆
# 只给参考音频,括号里可以加风格指令
wav = model.generate(
    text="(稍快一点,欢快的语气)这是带风格控制的克隆语音。",
    reference_wav_path="path/to/voice.wav",
)
sf.write("clone.wav", wav, model.tts_model.sample_rate)

# 极致克隆:参考音频加逐字稿
wav = model.generate(
    text="这是使用VoxCPM2的极致克隆演示。",
    prompt_wav_path="path/to/voice.wav",
    prompt_text="参考音频的文本转录。",
    reference_wav_path="path/to/voice.wav",
)
sf.write("hifi_clone.wav", wav, model.tts_model.sample_rate)
命令行
voxcpm design --text "VoxCPM2带来全新语音合成体验。" --control "年轻女声,温暖温柔,略带微笑" --output out.wav
voxcpm clone --text "这是一个声音克隆的演示。" --reference-audio path/to/voice.wav --output out.wav
voxcpm batch --input input.txt --output-dir outs
部署成 API 服务
需要高并发时,官方推荐 Nano-vLLM-VoxCPM;vLLM 的全模态扩展 vLLM-Omni 也原生支持 VoxCPM2,能提供和 OpenAI 兼容的语音合成接口:
vllm serve openbmb/VoxCPM2 --omni --port 8000官方提醒,音色设计和可控克隆的结果每次生成会有差异,建议同一句多生成 1 到 3 次,挑最满意的。
声音克隆的法律和伦理边界
VoxCPM2 克隆出来的声音非常逼真,这也是它最容易被滥用的地方。官方在 README 里明确写着:严禁用于冒充他人、欺诈或传播虚假信息,并建议对所有 AI 生成内容做明确标注。
在国内使用,至少要注意这几条:
- 不得未经授权克隆他人声音:《民法典》规定自然人的声音参照肖像权保护;《互联网信息服务深度合成管理规定》要求,提供人声等生物识别信息编辑功能的,应当提示使用者依法告知被编辑的个人并取得其单独同意。克隆家人、朋友、主播、明星的声音,都要先拿到本人同意。
- AI 生成内容要标识:《人工智能生成合成内容标识办法》自 2025 年 9 月 1 日起施行,对外发布 AI 合成的语音,应按规定添加标识。
- 不要用于冒充和诈骗:用合成声音冒充他人打电话、骗取钱财或散布谣言,可能触犯刑法。
- 商用要看权利链:Apache-2.0 只授权你使用模型本身,不等于你有权使用某个人的声音;商用配音最好用音色设计生成的原创声音,或与声音提供者签书面授权。
以上只是常识性提醒,不构成法律意见,具体场景请咨询专业人士。
优缺点
优点:
- 音色设计很实用:不需要参考音频,用一句话就能得到原创音色,天然避开了声音授权问题。
- 一个模型覆盖 30 种语言和 9 种方言:多语种项目不用来回换模型。
- Apache-2.0 可商用:代码和权重都能免费商用。
- 48kHz 输出:适合视频、播客等对音质要求高的场景。
- 生态完善:有 Nano-vLLM、vLLM-Omni、GGUF、ONNX、ComfyUI 节点等多种部署方式。
缺点:
- 显存门槛高于小模型:约 8 GB,比 0.5B 级别的模型更吃显卡。
- 可控生成不够稳定:同一个描述每次生成的音色会有差异,需要多试几次。
- 部分语言表现一般:官方公布的多语种测试里,阿拉伯语、捷克语、罗马尼亚语等的错词率明显偏高。
- Windows 环境容易踩坑:Triton 和 torch.compile 相关报错较多。
适合谁
- 做短视频、有声书、课程配音,需要多种音色又不想买商用音色库的创作者。
- 想在自己的产品里集成可商用 TTS 的开发者。
- 有 8 GB 以上显存 NVIDIA 显卡、愿意折腾本地部署的 AI 爱好者。
如果你只有 CPU 或者对速度要求很高,可以先用在线 Demo 体验,或者考虑更小的模型。
和同类开源 TTS 对比
| 对比项 | VoxCPM2 | CosyVoice | F5-TTS | GPT-SoVITS | Fish Speech |
|---|---|---|---|---|---|
| 开发方 | 面壁智能、清华 | 阿里通义 | 上海交大 X-LANCE 等 | RVC-Boss 社区 | Fish Audio |
| 最新模型 | VoxCPM2,2B | Fun-CosyVoice3,0.5B | F5-TTS v1 | v4 等多个版本 | S2 Pro,4B |
| 文本描述生成音色 | 支持 | 支持情绪、语速、方言等指令 | 未提供 | 未提供 | 支持细粒度情绪标签 |
| 声音克隆 | 零样本,可不带逐字稿 | 零样本 | 零样本,需参考文本 | 5 秒零样本,1 分钟微调 | 零样本 |
| 语言 | 30 种加 9 种方言 | 9 种加 18 种以上方言口音 | 官方基础模型以中英为主 | 中英日韩粤等 | 80 种以上 |
| 协议 | Apache-2.0,可商用 | Apache-2.0 | 代码 MIT,权重 CC-BY-NC 非商用 | MIT | Fish Audio 研究许可,商用需另行授权 |
| GitHub 星数 | 约 3.86 万 | 约 2.39 万 | 约 1.54 万 | 约 6.27 万 | 约 3.30 万 |
表中信息来自各项目 GitHub README 和许可证文件,星数为 2026 年 10 月 11 日数据。
效果方面,VoxCPM 团队在 README 里公布了 Seed-TTS-eval 测试结果:中文测试集上 VoxCPM2 的字错率为 0.97%,CosyVoice2 为 1.38%,F5-TTS 为 1.53%,Fish Audio S2 为 0.54%;说话人相似度 VoxCPM2 为 79.5%,在开源模型里处于前列。这些是 VoxCPM 团队自己整理的数据,不同项目的测试条件不完全相同,仅供参考。
怎么选:
- 要音色设计加商用授权:VoxCPM2 最合适。
- 主要做中文方言:CosyVoice 的方言口音覆盖更广。
- 想用自己的数据精细训练一个声音:GPT-SoVITS 社区教程最多,整合包和中文资料丰富。
- 追求多语种覆盖和情绪控制、只做非商业用途:可以试试 Fish Speech。
- 学术研究:F5-TTS 代码简洁,但权重不能商用。
项目信息
| 项目 | 信息 |
|---|---|
| 名称 | VoxCPM2 |
| 开发方 | 面壁智能(OpenBMB)、清华大学人机语音交互实验室 |
| GitHub | OpenBMB/VoxCPM |
| 开源协议 | Apache-2.0(代码和权重) |
| 当前版本 | 2.0.3(2026 年 5 月) |
| 参数量 | 20 亿 |
| 输出采样率 | 48kHz |
| 支持语言 | 30 种语言、9 种中文方言 |
| 推理显存 | 约 8 GB(官方参考值) |
| 运行环境 | Python 3.10 到 3.12,PyTorch 2.5 以上,CUDA 12.0 以上;也支持 CPU 和 Apple MPS |
| 模型下载 | Hugging Face:openbmb/VoxCPM2;ModelScope:OpenBMB/VoxCPM2 |
| GitHub 星数 | 约 3.86 万(2026-10-11) |


