


用 Claude Code、Codex 跑长任务时,真正把上下文撑满的往往不是你写的提示词,而是工具输出:一次 gh 接口返回几万 token 的 JSON,一份测试日志几百行全是 INFO,模型读完一遍,窗口就去了一大块,账单也跟着涨。
Headroom 做的是这件事的“中间层”:工具输出、日志、文件内容和 RAG 片段在发给模型之前,先在你自己的电脑上压缩一遍,原文缓存在本地,模型需要时再取回来。它是 Apache-2.0 开源项目,今年 1 月才建仓,写这篇时 GitHub 约 7.7 万星,今天还在 GitHub Trending 日榜上。
官方 README 给的数字很亮眼,我们更想知道自己的数据能省多少。下面是在 Linux 上装 0.41.0 版、用两段真实形态的工具输出实测的结果,以及三种接入方式和使用前要注意的几件事。资料查阅和测试于 2026-10-22。
先看实测:日志省 98%,杂乱 JSON 只省 27%
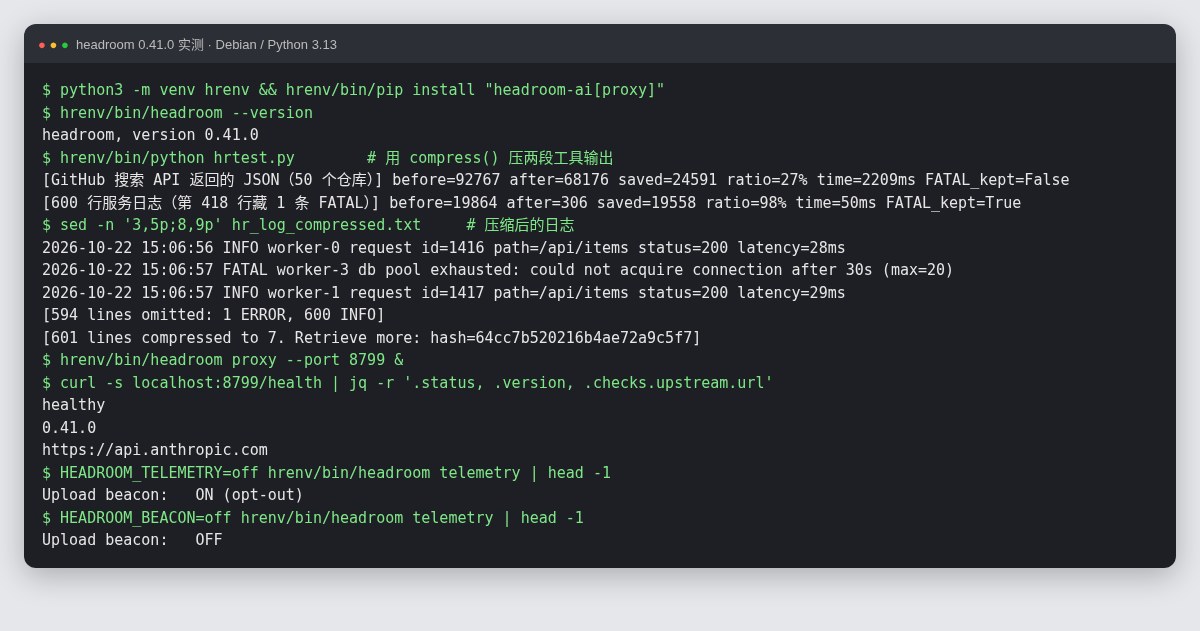
我们用 Python 库里的 compress() 函数,把两段内容当作工具返回结果交给它:
| 测试内容 | 压缩前 | 压缩后 | 节省 | 耗时 |
|---|---|---|---|---|
| 600 行服务日志,第 418 行藏 1 条 FATAL | 19,864 token | 306 token | 98% | 约 50 毫秒 |
| GitHub 搜索 API 返回的 JSON(50 个仓库,字段很多) | 92,767 token | 68,176 token | 27% | 约 2.2 秒(首次调用,含加载) |
日志那一项,Headroom 把 601 行压成 7 行:FATAL 那一行原样保留,前后各留了几行上下文,其余用一行摘要代替([594 lines omitted ...]),最后附上一个哈希值,模型想看全文可以凭它取回。重复度高的日志正是它最擅长的场景。小瑕疵是摘要里写着“1 ERROR”,其实原文里没有 ERROR,只有那条 FATAL,看摘要时别全信计数。
GitHub JSON 只省了 27%,原因也很直观:50 个仓库对象各有 80 多个字段、值都不一样,能删的冗余不多。Headroom 做的是把对象数组改写成“先列一次字段名、再逐行放值”的紧凑表格,省掉了重复的键名。这和官方的说法一致:内容越重复省得越多,散文和本来就很紧凑的输出几乎压不动。
官方 README 里的四个基准场景(代码搜索、线上故障排查、浏览代码库、GitHub Issue 分拣)节省 21%~57%,跑在真实 MCP 输出格式上,数字和我们的体感接近:别指望每次都省一大半,日志和重复 JSON 多的任务收益最大。
它是怎么压的
Headroom 先判断内容类型,再交给对应的压缩器:
- JSON:SmartCrusher 按字段统计挑出要保留的条目,错误项、异常值和首尾几条会留下;
- 代码:CodeCompressor 按语法树压缩,支持 Python、JS/TS、Go、Rust、Java、C/C++、C#、PHP;
- 普通文本和日志:用官方在 Hugging Face 上发布的 Kompress-v2-base 模型;
- 可逆:被删掉的原文按哈希缓存在本机,模型通过
headroom_retrieve工具取回,这就是 README 里说的 CCR。
压缩在本机完成,提示词和文件内容不会发到 Headroom 的服务器。
三种接法,按你的情况选
1. 包装编程助手(最省事)
uv tool install --python 3.13 "headroom-ai[all]"
headroom wrap claude      # 或 codex、copilot、aider、opencode 等
headroom unwrap claude    # 不想用了,一条命令还原
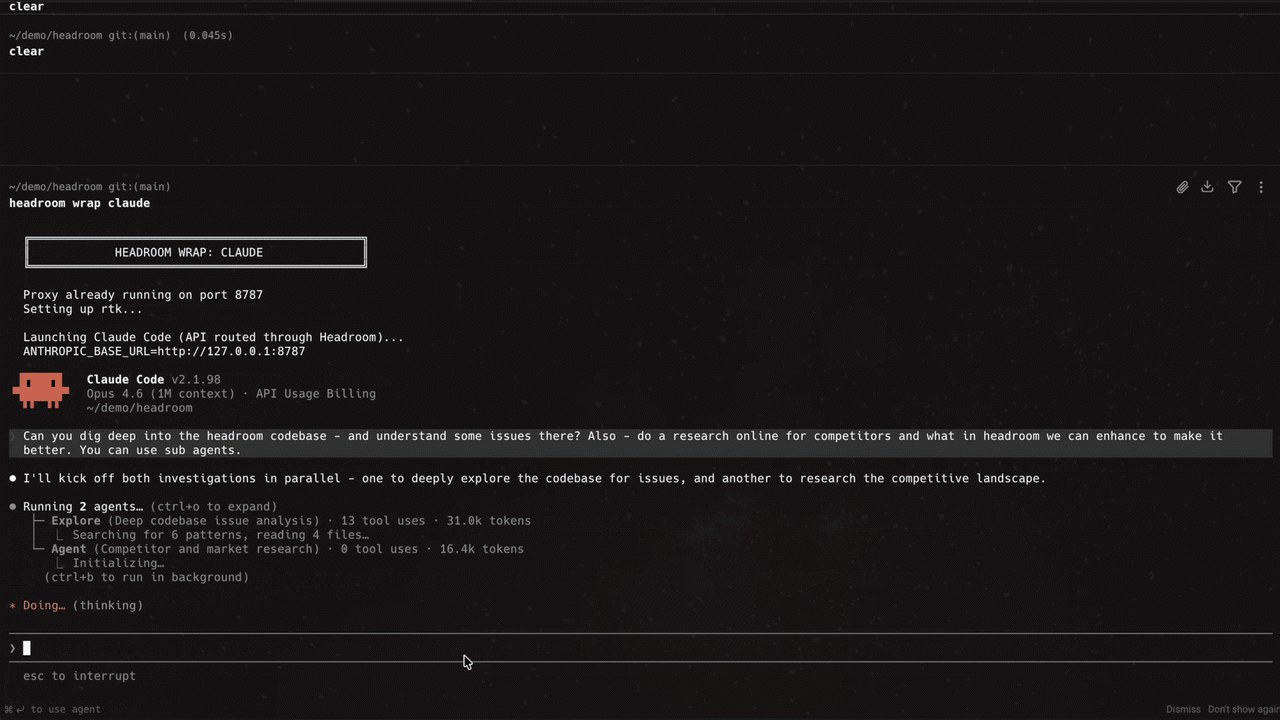
headroom wrap 会在本机起一个代理、改好环境变量,再启动 Claude Code。官方列出支持 wrap 的有 Claude Code、Codex、Grok CLI、Copilot CLI、VS Code Copilot、Aider、OpenCode、Cline、Continue、Goose、OpenHands、Kimi CLI 等十几种;Cursor 和 ZCode 只会打印配置地址,要自己填。注意:wrap 默认还会顺手装一个代码导航工具 Serena(注册为当前项目的 MCP 服务),不想要就加 --code-memory none。
2. 单独跑代理,不改代码
pip install "headroom-ai[proxy]"
headroom proxy --port 8787
# Claude Code:ANTHROPIC_BASE_URL=http://127.0.0.1:8787 claude
# OpenAI 兼容客户端:OPENAI_BASE_URL=http://127.0.0.1:8787/v1
我们第一次只装了基础包 headroom-ai,运行 headroom proxy 直接报错“Proxy dependencies not installed”,补装 [proxy] 之后才启动成功,/health 返回 healthy,默认转发到 api.anthropic.com 和 api.openai.com。代理默认只监听 127.0.0.1。
如果你用 DeepSeek 等第三方 OpenAI 兼容接口,官方特别提醒要加 --openai-api-url https://api.deepseek.com/v1(或设置 OPENAI_TARGET_API_URL),否则请求会被转去 OpenAI,报 401。已经在用 Magpie 这类本机网关切换模型的,要想清楚两层代理谁在前、谁在后。
3. 写进自己的程序
from headroom import compress
result = compress(messages, model="gpt-4o")
print(result.tokens_saved, result.compression_ratio)
Python 3.10 以上即可,另有 TypeScript SDK(npm install headroom-ai,只是库,不带 headroom 命令),还提供 LangChain、Vercel AI SDK、LiteLLM 回调等集成。MCP 客户端可以用 headroom mcp install 接入。
用之前要知道的几件事
- 遥测默认开启。 官方说只上报压缩比、计数、模型名、系统类型,不含提示词和代码。README 写的关闭方式有
HEADROOM_BEACON=off、HEADROOM_TELEMETRY=off、DO_NOT_TRACK=1。我们实测 0.41.0:只设HEADROOM_TELEMETRY=off时,headroom telemetry显示的仍是“Upload beacon: ON”;设HEADROOM_BEACON=off或DO_NOT_TRACK=1才显示 OFF。想确定关掉,用后两个。 - 它会改编程助手的配置。
wrap会写环境变量、注册 MCP 服务;--1m这类选项还会改 Claude Code 的用户设置。官方提供了unwrap还原,但第一次用最好先备份~/.claude.json。 - Intel Mac 可能要折腾。 README 一处写原生包只覆盖 Apple 芯片 Mac 和 Linux、Intel Mac 建议用 Docker 版,另一处又说 Intel Mac 也有 wheel,并提到 ONNX Runtime 没有 Intel Mac 预编译版(Issue #941)。用 Intel Mac 的,直接走 Docker 最省心。
- 短对话没什么用。 官方自己也写了:简短问答、散文、已经很紧凑的内容基本不省,太短的块会原样返回。它适合的是长会话、工具输出很多的 Agent 任务。
- 团队版要付费,开源版功能完整。 官网在推 Headroom for Teams(SSO、集中配置等),签一年送 3 个月;仓库里的代码仍是 Apache-2.0,个人用不需要账号。
- 项目迭代很快。 0.39.1 到 0.41.0 只隔了不到三周,配置项和命令可能变,以官方文档为准。
和 Context Mode、Graphify 有什么不同
这几个工具都在帮编程助手省上下文,但切入点不一样:
| 工具 | 管什么 | 怎么做 |
|---|---|---|
| Headroom | 所有发给模型的内容 | 本机代理或库,按内容类型压缩,原文可取回 |
| Context Mode | 工具输出 | 大输出先在沙箱里跑,只把结果送进对话 |
| Graphify | 读代码 | 把项目建成知识图谱,查图代替翻文件 |
Headroom 在最外层,能和另外两个叠着用,README 里也把 Graphify 列为可以搭配的工具。编程助手周边还有哪些类别的工具,可以看本站的 AI 编程 Agent 生态全景。
适合谁
- 每天开着 Claude Code、Codex 跑测试、看日志、调接口的人,尤其是按 API 用量付费的;
- 自己写 Agent 或 RAG 应用、想在调用模型前先削减 token 的开发者;
- 同时用好几个编程助手、想用一个代理统一处理的人。
偶尔问两句代码、用订阅额度足够的,不必折腾。想试的话,建议先跑 headroom proxy 加一个项目试一天,再用 headroom savings 看自己的流量到底省了多少,比看官方数字更准。
相关链接
- GitHub:headroomlabs-ai/headroom
- 官方文档:docs.headroomlabs.ai
- PyPI:headroom-ai
- 文本压缩模型:Kompress-v2-base


