


给自己拍的讲解、采访或会议录像出字幕时,常见的路子是把文件传到云端转写网站,或先注册再等积分。若这段录音里有不方便上传的内容,或者只是偶尔做一次字幕、不想为此开账号,就会很别扭。
Media to Words 把这件事收成一个网页:选择本地音频或视频,在浏览器里识别讲话,再复制文字,或下载带时间码的 TXT 和 SRT。页面写明:走「Upload file」时,录音留在你的设备上,识别在浏览器里跑;第一次使用会下载语音模型,所以仍需要联网。2026-11-13,我们用两段已知文稿的测试材料走完了这条路径,并用 Chrome 开发者工具看了当时的网络请求。下面只写实际看到的结果,以及它明显不适合的地方。
适合谁、先看清什么
适合手里已经有一份有权处理的音视频、只想尽快得到可修改的逐字稿或 SRT、又不想先注册、也不想把整段录音传到云端识别服务的人。它不做翻译,不按说话人分开标注,也没有我们能找到的付费升级页(/pricing 返回 404)。界面目前是英文。
用之前先确认:这段录音你有权转成文字或字幕。自动识别仍要对照原声复听,尤其是人名、数字、专有名词和背景很吵的片段。
| 项目 | 情况(查阅并实测于 2026-11-13) |
|---|---|
| 地址 | https://mediatowords.com/ |
| 模式 | 默认是「Reel link」(贴公开的 Instagram 链接,本次未测);我们测的是「Upload file」 |
| 输入 | 选一个本地音频或视频,最大 250 MiB,一次一个文件。页面不提供固定的扩展名白名单,能否解码取决于浏览器和文件里的音轨 |
| 语言 | 下拉框有 Auto-detect,以及 English、Spanish、French、German、Indonesian、Portuguese、Chinese、Japanese、Korean、Arabic、Hindi、Italian。本次两次测试都显式选了 English,未测中文和自动检测 |
| 输出 | 页面上可编辑的逐行转写;Copy text、Download TXT、Download SRT。TXT 每行带起始时间,SRT 是带起止时间的字幕条目 |
| 账号与价格 | 不必登录。本次没有看到付费墙或套餐 |
| 识别模型(本次抓包,不是官方宣传口径) | 浏览器从本站下载了 Xenova whisper-tiny 的 ONNX 模型,脚本和 wasm 来自 jsDelivr。这是较小的 Whisper 模型,不能按「大模型转写精度」来预期 |
「文件留在设备上」不等于完全离线。第一次使用必须联网下载模型和脚本;我们还看到若干体积很小的统计请求。隐私政策也写了:Cloudflare 提供站点与模型文件,jsDelivr 提供转写脚本,这些连接会向相应服务商暴露 IP。若你提交的是 Instagram 链接,则是另一条路径:链接会先发到他们的 Cloudflare 中继去取公开视频,再在浏览器里识别。这条我们没有测。
怎么转一次,再怎么验收
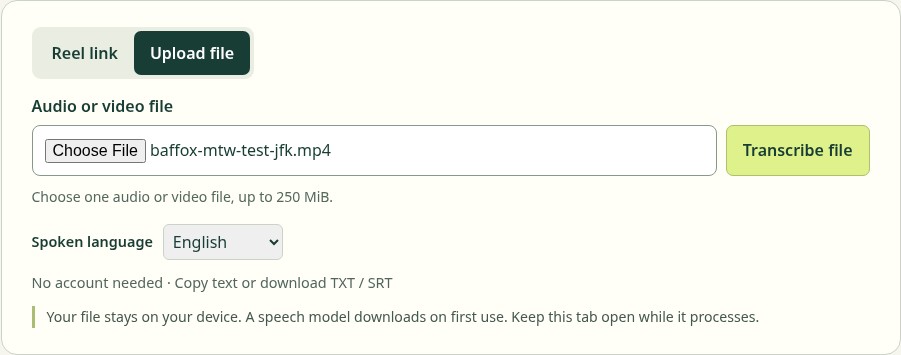
- 打开 https://mediatowords.com/,切到 Upload file。不必先注册。本次打开时没有弹出 cookie 横幅。
- 点 Choose File,选一份不超过 250 MiB、里面有清晰人声的音频或视频。页面会显示文件名。
- 在 Spoken language 里选讲话所用的语言。知道是英语就选 English,不要依赖自动检测——自动检测本次没测。
- 点 Transcribe file,并保持这个标签页开着。控件在处理期间会变为不可用。第一次使用会依次出现 “Reading audio…”、“Preparing speech recognition…” 和 “Downloading speech model file: … MiB received”。进度百分比可能会在新文件开始下载时跳回较小的数字,这不一定是卡住。我们第一次从点击到出结果用了 3 分 36 秒,其中大部分时间在下模型;同一天稍后再转一段,模型已经在浏览器里,大约 4.1 秒 就出了结果。
- 结果卡片写的是 “Complete · Transcribed on this device”。先看两行核对信息:Recording length 和 Last recognized speech ends at。若最后识别到的讲话结束时间明显短于录音长度,先不要导出,对照页内播放器听结尾——页面自己也提示,末尾的空档可能是静音,时间码不能单独证明转写是完整的。
- 对着声音改每一行,尤其是人名、数字和术语。改的是文字,字幕时间轴保持不变。我们实测:改完再下载,TXT 和 SRT 里都带上了修改,SRT 的起止时间没有跟着变。
- 需要纯文字笔记就下载 TXT,需要导入剪辑软件就下载 SRT。保存后再关页,刷新会丢掉未下载的结果。
处理过程中请保持网络畅通,直到模型下载结束。涉密或未授权的录音不要用这个流程。
我们实际测了两段已知文稿的材料
测试时间是 2026-11-13,浏览器是这台机器上的 Chrome,没有登录。
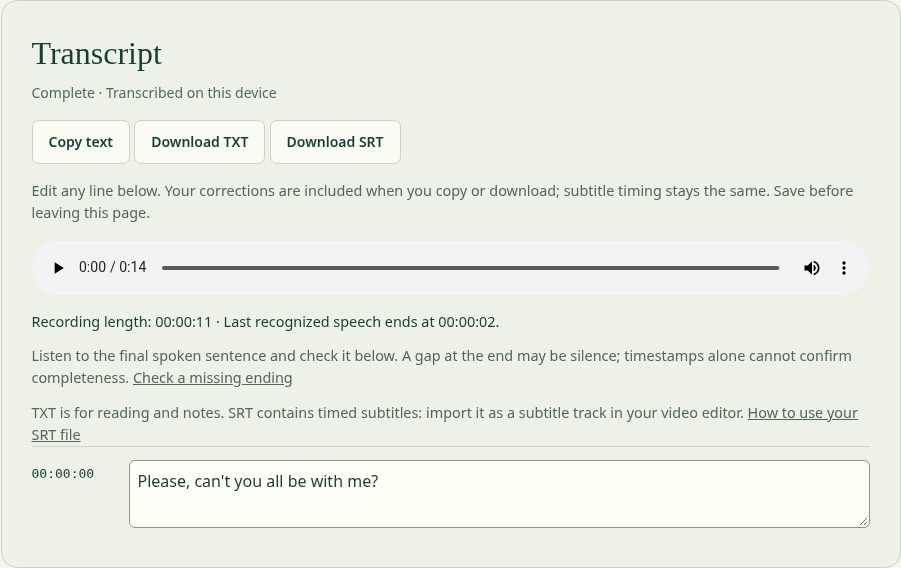
第一段是我们用 espeak-ng 合成的英语朗读,再封进 MP4:文稿是事先写好的,包含人名 Alice Chen、日期 November thirteenth、时刻 three thirty、金额 two thousand four hundred dollars,以及文件名 Project River draft three。音频大约 12 秒,封装后的视频长约 14.44 秒(末尾多了一点画面)。语言选 English。第一次使用,从点击到出结果 3 分 36 秒。页内播放器显示 0:14,但卡片写的是 Recording length 00:00:11、Last recognized speech ends at 00:00:02。整段识别结果只有一行:
Please, can't you all be with me?
除了开头的 Please,和原稿对不上。导出的 SRT 起止时间是 00:00:00,000 --> 00:00:02,000,也和「只认到第 2 秒」一致。这段是电子合成音,和真人讲话差别很大,不能当成它对自然语音的结论;它只说明:流程能走完、文件能导出,但识别质量不能假定。
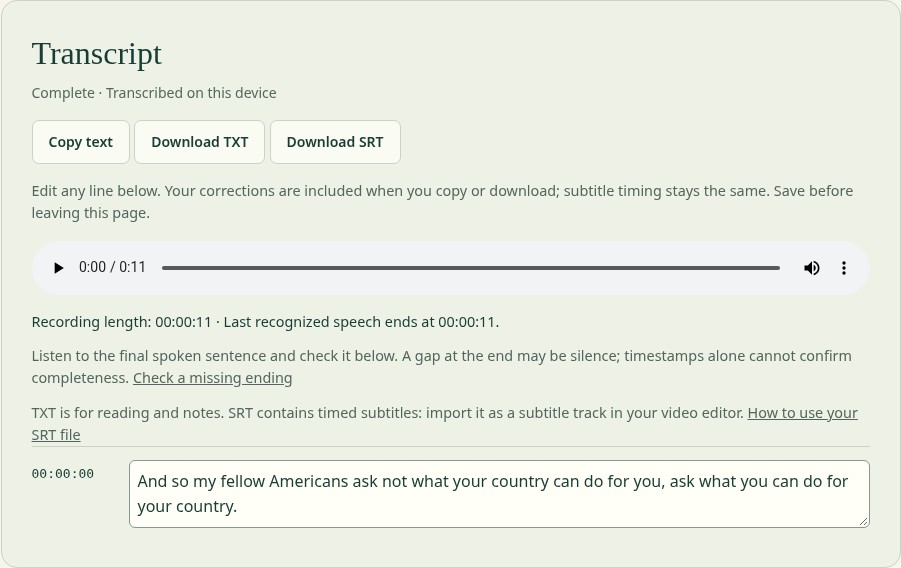
同一天稍晚,我们改用 OpenAI Whisper 仓库里常用的测试音频 tests/jfk.flac(约 11 秒的真人演讲片段),同样封成 MP4,仍选 English。这一次没有再出现模型下载提示,从点击到 “Transcript ready” 大约 4.1 秒。播放器、Recording length、Last recognized speech ends at,以及导出 SRT 的结束时间,都是 11 秒,彼此一致。页面上的完整结果是一行:
And so my fellow Americans ask not what your country can do for you, ask what you can do for your country.
对照常见引用文本,单词和词序一致,没有漏词、加词或换词;差别只在标点:so 后面没有逗号,Americans 后面没有冒号,第二处 ask 前面用了逗号而不是破折号。对出字幕来说,这已经能用,仍建议按自己的标点习惯改一改。
这次测试不能代表中文、嘈杂现场、多人重叠或很长的课程录像。站点用的是较小的 whisper-tiny,遇到合成音、口音重、音乐很响的材料时,请把复听当成必做步骤,而不是可选项。
关于文件去向:在第一段测试里,我们打开了开发者工具的 Network 并保留日志。测试 MP4 大约 190 KB,但所有 POST 加起来只有约 2.6 KB,状态码是 204;打开其中一条,地址是 https://mediatowords.com/count/home/file/txt,更像点击导出时的计数,而不是把媒体文件传上去。大流量是模型下载:decoder 约 30.8 MB、encoder 约 10.1 MB,再加上 tokenizer 和 jsDelivr 上的脚本、wasm,这一次一共约 23 个请求、传输约 43.6 MB。页内试听用的是本地 blob: 地址。我们没有打开每一个请求的正文,所以不能写成「检查过全部载荷」,但就体积和可见地址而言,没有看到把这段 MP4 上传到识别接口的迹象。这只对「Upload file」这次操作有效,不能套到未测的 Instagram 链接模式。
另外:点 Copy text 后,按钮文案没有变成 “Copied”,也没有弹出提示。我们没有在这台机器上独立核对剪贴板,因此不把「复制一定成功」写成已验证。需要留下结果时,请以下载的 TXT 或 SRT 为准。
常见失败和限制
- 没有权利处理的音视频不要传,也不要贴无权获取的链接。转成文字或字幕,并不等于可以公开发布。
- 自动识别会错。人名、数字、术语和背景音乐重的片段尤其要复听。我们用合成音测到的那次,结果几乎不可用。
- 请核对「最后识别到的讲话结束时间」是不是明显短于录音。对不上就先听结尾,再决定要不要用这份字幕。
- 一次只能处理一个不超过 250 MiB 的文件。页面不保证所有扩展名都能解码;若提示无法解码,可先在本地转出一份常见格式的音轨再试。
- 第一次使用要下载约几十 MB 的模型,需要时间,也需要网络。模型缓存之后会快很多,但换浏览器、清缓存后可能还要再下一次。
- 没有看到可切换的更大模型,也没有测中文、自动检测、批量处理和接近 250 MiB 的大文件。
- Instagram 的 Reel link 模式会把公开链接交给他们的服务器去取视频,和「本地文件不上传」不是同一条路径,本次没有测。
- 这是独立网页工具,模型和流程以后都可能改,以当时页面和隐私政策为准。
和别的办法怎么选
若你要处理的是 B 站、YouTube、抖音上的公开课或长教程,而且希望直接得到带时间戳的笔记和思维导图,而不是自己对着 SRT 整理,更适合看站内的 a2md。它是要注册的云端服务,文件会上传,和 Media to Words 的取舍正好相反。
若你要的不是「把一段已经录好的视频写成稿」,而是一边说话、一边把字贴进当前输入框,并且希望完全离线,可以看 Handy。那是装在电脑上的开源听写工具,不是网页转字幕。
若还想在自己电脑上做声音克隆、视频配音,并把转写放进同一条本地工作流,可以看 VoiceStudio。它比这个网页重,但也更完整。
只是视频太大、要先在浏览器里把体积压下去、同样不想上传,可以另看 Make Video Smaller。那是压缩,不是转写。
若要处理的不是讲话,而是一段嘀嘀嗒嗒的摩斯电码录音,可以看 Morse Code Translator。2026-11-15 用自制的「BAFFOX 15」录音在浏览器里解码,干净版本和加噪版本都得到了正确原文。
小结
Media to Words 的「Upload file」适合偶尔要给自己的录像出一份可改的 TXT 或 SRT、又不想先注册、也不想把录音传到云端识别的人。2026-11-13 的两次测试里,流程、导出和修改后再下载都成立;第一次下模型较慢,之后同一浏览器里只需数秒。一段常见的真人英语测试音频,单词和词序是对的;一段合成英语则几乎没认对。请把它当成「先出一版再校对」的工具,而不是可以不听原声就发布的字幕机。


