


收到一封邮件、一篇稿或一条帖子,有时想先看看哪些句子读起来像 AI 写的,又不想先注册账号。这和我们已经写过的 Hikaku 不是同一件事:Hikaku 标的是网页里的图片或视频像不像 AI 生成,并且在本机跑;Sniffy 针对的是文本,用法是在网页里粘贴。
2026-11-21,我们在桌面 Chrome 里打开了 https://getsniffy.com/,没有注册,也没有安装扩展。下面先跑了站点自带的两个 Sample,再跑了 4 组我们自己写的测试文本。这些文字都是为这次检测编的,没有粘贴任何人的真实邮件或稿件。
打开时页面标题是 “Free AI Detector: Check Any Text for AI, No Sign-Up | Sniffy”,界面是英文。首屏写着 Free AI detector,并强调免费、免注册。我们没有看到 cookie 横幅,也没有登录墙或价格表。页上写一次最多约 12,000 词,并建议至少 50 词,否则只给粗略估计。粘贴区在页面中部,标签是 “Text to check”,旁边有 “Sniff it”、“Sample: AI post” 和 “Sample: Thoreau, 1854”。右侧是结果区。页上还有 Chrome 扩展的介绍和若干演示帖,那些徽章是站点为说明页面准备的样例,不是我们这次粘贴出来的结果。扩展不是这篇的测试范围,我们没有安装。
适合谁、怎么贴一段文字
适合想先得到一个「这段话里哪些句子看起来像 AI 写的」的参考,又不想先开账号的人。它不是查重系统,也不能当录用、作业或学术不端的证据。页面自己也写:没有检测器是完美的,把结果当作提示,而不是证明。
用法很直接:
- 打开 https://getsniffy.com/,不必登录。往下滚到 “Paste anything.” 这一块。
- 把文本贴进左侧输入框,或先点站点自带的 Sample 看它今天怎么标自己的例子。
- 点 “Sniff it”,等右侧出现百分比、标签、区间和逐句高亮。
- 先看标签和区间,再看哪些句子被标了颜色。不要只看一个整数百分比。
贴文字之前请先换成不涉及他人隐私的测试稿。下面的英文套话、中文琐事和混合稿,都是 baffox 在 2026-11-21 自己写的。
站点样例今天给出了什么
这两个结果是站点自己的样例在今天的分数,不是我们写的原文,也不能当成它对整个互联网的准确率。
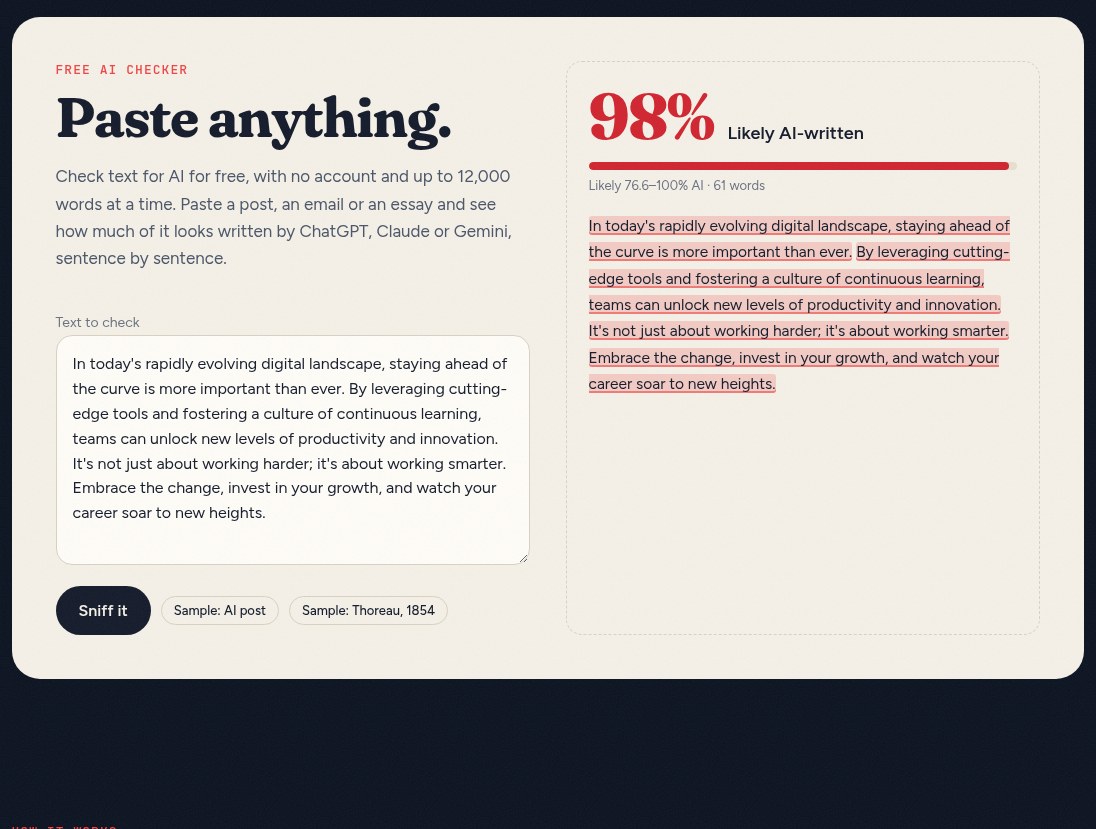
点 “Sample: AI post” 后,输入框里出现一段关于 “digital landscape”“cutting-edge tools” 的套话,约 61 词。约 3 秒后,右侧给出 98%、标签 Likely AI-written,并写 Likely 76.6–100% AI。四句的模型概率分别约为 0.982、0.987、0.976、0.977,几乎整段都被标成偏 AI 的颜色。检测请求在服务器上标了 0.19 秒。
点 “Sample: Thoreau, 1854” 后,输入框换成《瓦尔登湖》里 “I went to the woods because I wished to live deliberately…” 那几句,约 83 词。结果是 1%、No clear sign of AI,区间是 Likely 0–22.5% AI。三句的概率约为 0.011、0.008、0.008,正文几乎没有高亮。
我们自己写的文本,实测并不总是「套话就判 AI、口语就判人写」
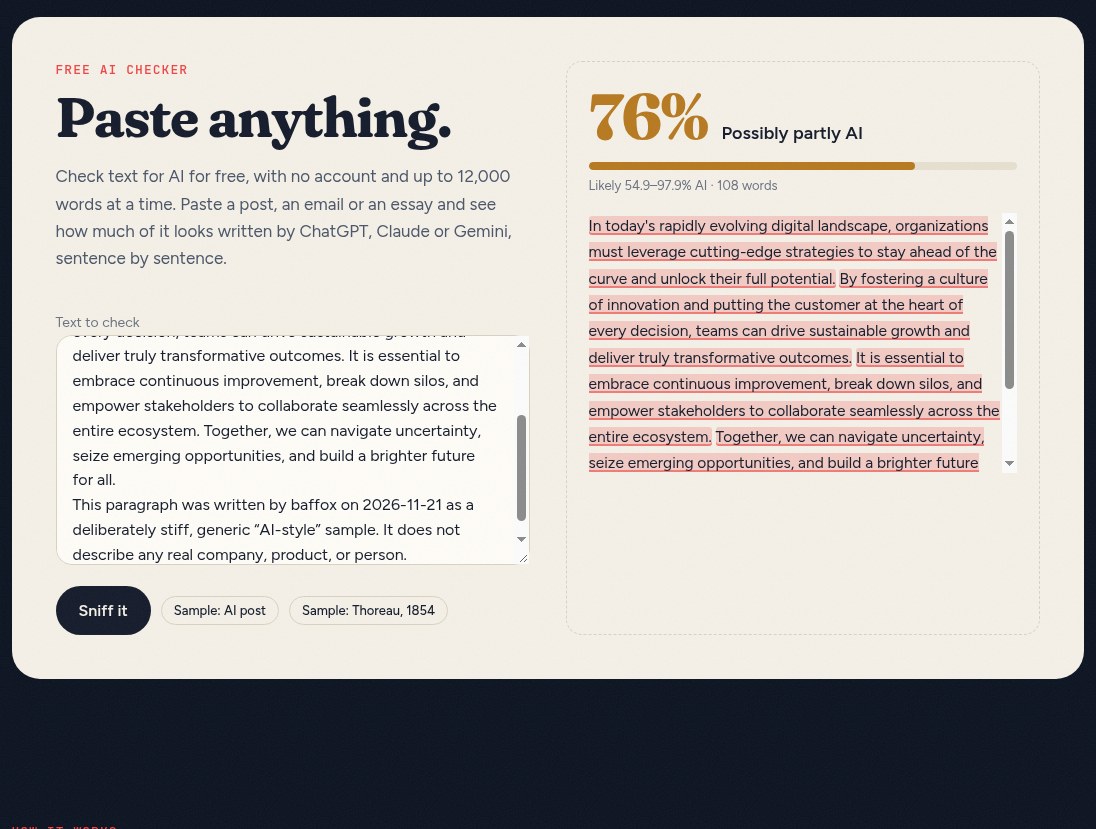
第一组是我们故意写的英文套话,108 个词,里面堆了 “rapidly evolving digital landscape”“unlock their full potential”“brighter future for all” 这类句子,末尾另有两句说明这是 baffox 在 2026-11-21 写的测试稿。结果不是干脆的 “Likely AI-written”,而是 76%、Possibly partly AI,区间 Likely 54.9–97.9% AI。前面四句套话的概率约为 0.999、0.980、0.982、0.966,都被高亮;最后两句说明文字的概率只有约 0.033 和 0.044,没有按同样的方式标成套话。整段因此被拉成「可能部分是 AI」,而不是和站点 Sample 那样的 98%。
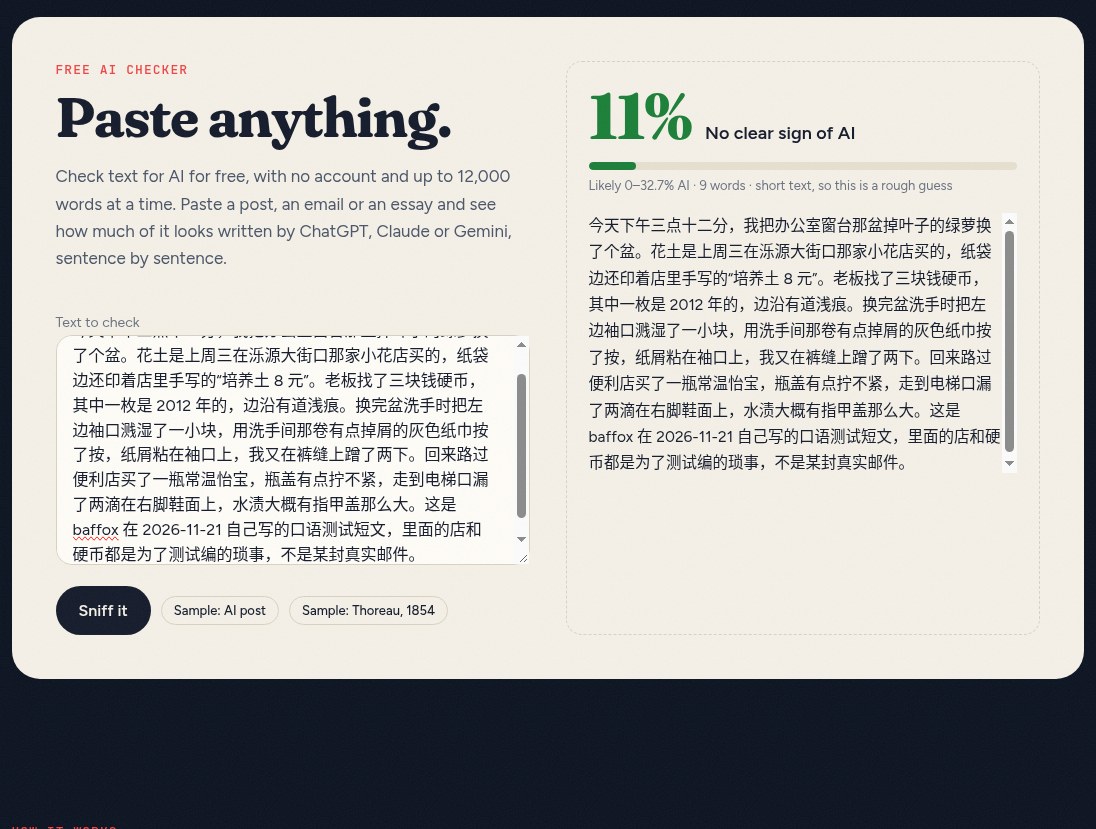
第二组是一段我们自己写的中文口语,讲换绿萝盆、泺源大街口花店、2012 年硬币和鞋面上两滴水,全文 271 个字符。页面接受了中文,没有报错,也没有要求改成英文。但词数被计成 9 words,并明确写着 short text, so this is a rough guess。结果是 11%、No clear sign of AI,区间 Likely 0–32.7% AI,整段被当成一句,概率约 0.111。这次中文没有被误标成 AI,可它同时被当成「太短」,参考价值有限。站点建议至少 50 词;按空格分词的话,这段中文远远不够。
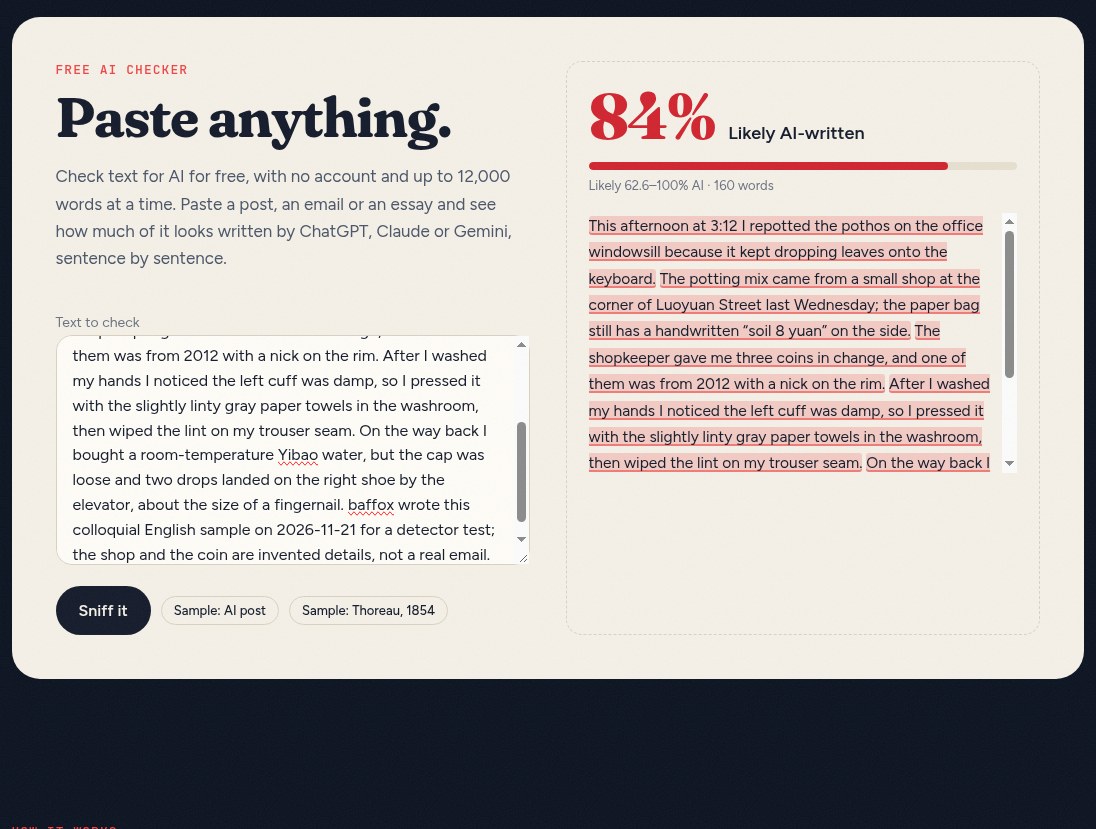
因为中文被当成短文本,我们补了一段意思相近的英文口语,160 个词,同样是换盆、花店纸袋、2012 年硬币和鞋面上的水,并注明是 2026-11-21 的测试稿。结果却是 84%、Likely AI-written,区间 Likely 62.6–100% AI。前五句的概率约为 0.966、0.975、0.931、0.843、0.865,几乎整段都被高亮;只有最后一句说明这是测试稿的句子稍低,约为 0.462。这是一次清楚的误判:这段话是我们手写的、带着具体琐事的口语,并不是 AI 生成的稿件,却被标成 “Likely AI-written”。
第四组把两句英文套话、一段中文琐事和一句说明拼在一起,88 个词。结果是 70%、Possibly partly AI,区间 Likely 48.6–91.6% AI。两句英文套话的概率约为 0.935 和 0.923;中间那段中文只有约 0.053;说明句约为 0.551 和 0.637。混合稿里,套话和中文琐事的分数确实不一样,但整段仍被写成「可能部分是 AI」,不能把它理解成已经把中文部分「排除干净」。
这四组都在数秒内出结果(我们从点按钮到右侧出现完整标签,大约 1.7 到 2.5 秒)。没有截断报错,也没有要求登录。
粘贴时文字被送到了哪里
页面的隐私说明写着:只有被检测的文本会送去打分,并且不会存储;唯一例外是你从徽章里举报误判时。这是它的说明,不是审计结论。
我们在跑 Sample 和自制文本时,每次点 “Sniff it” 或 Sample,浏览器都会把完整正文以 JSON 形式 POST 到 https://avysotsky-ai-text-detector.hf.space/v1/detect,也就是 Hugging Face 上的一个检测接口,并收到带 ai_percent、verdict、likely_range_percent 和逐句 ai_probability 的 JSON。这不是在浏览器本地完成的判断。不要把它写成「文件不过网」或「隐私离线」。我们没有去验证它是否按声明那样不保存文本。
若你之后考虑安装它的 Chrome 扩展,扩展本身这次没有测。装之前可以先用 CRX8 看它要了哪些权限,再决定要不要装。不要根据商店或官网的介绍,把它理解成已经审过。
常见失败和限制
- 这只是模型给出的参考。不能拿来当作业查重、录用筛选或学术不端的证据,也不能写成「已经识破 AI」。
- 我们手写的英文口语短文被标成 84%、Likely AI-written。口语、具体琐事,并不能保证会被标成 Human。
- 故意写的英文套话也没有得到 98% 那样的定性,而是 76%、Possibly partly AI,因为文末两句说明把整段分数拉低了。同一个工具,对「看起来像套话」的判断会随前后句子变化。
- 中文可以粘贴,但这次按空格只计到 9 个词,并提示结果只是粗略估计。不能把 11% 理解成「中文识别得很准」。
- 站点 Sample 的 98% 和 1% 只说明这两个例子今天是这样标的,不能外推成准确率。
- 文本会发送到
avysotsky-ai-text-detector.hf.space。不要把 Sniffy 和在本机标记图片的 Hikaku,或在浏览器里本地处理文件的工具写成同一类。 - Chrome 扩展、在 X / LinkedIn / Reddit 上滚动打徽章,以及超过 12,000 词的文本,这次都没有测。


